빠른 요약
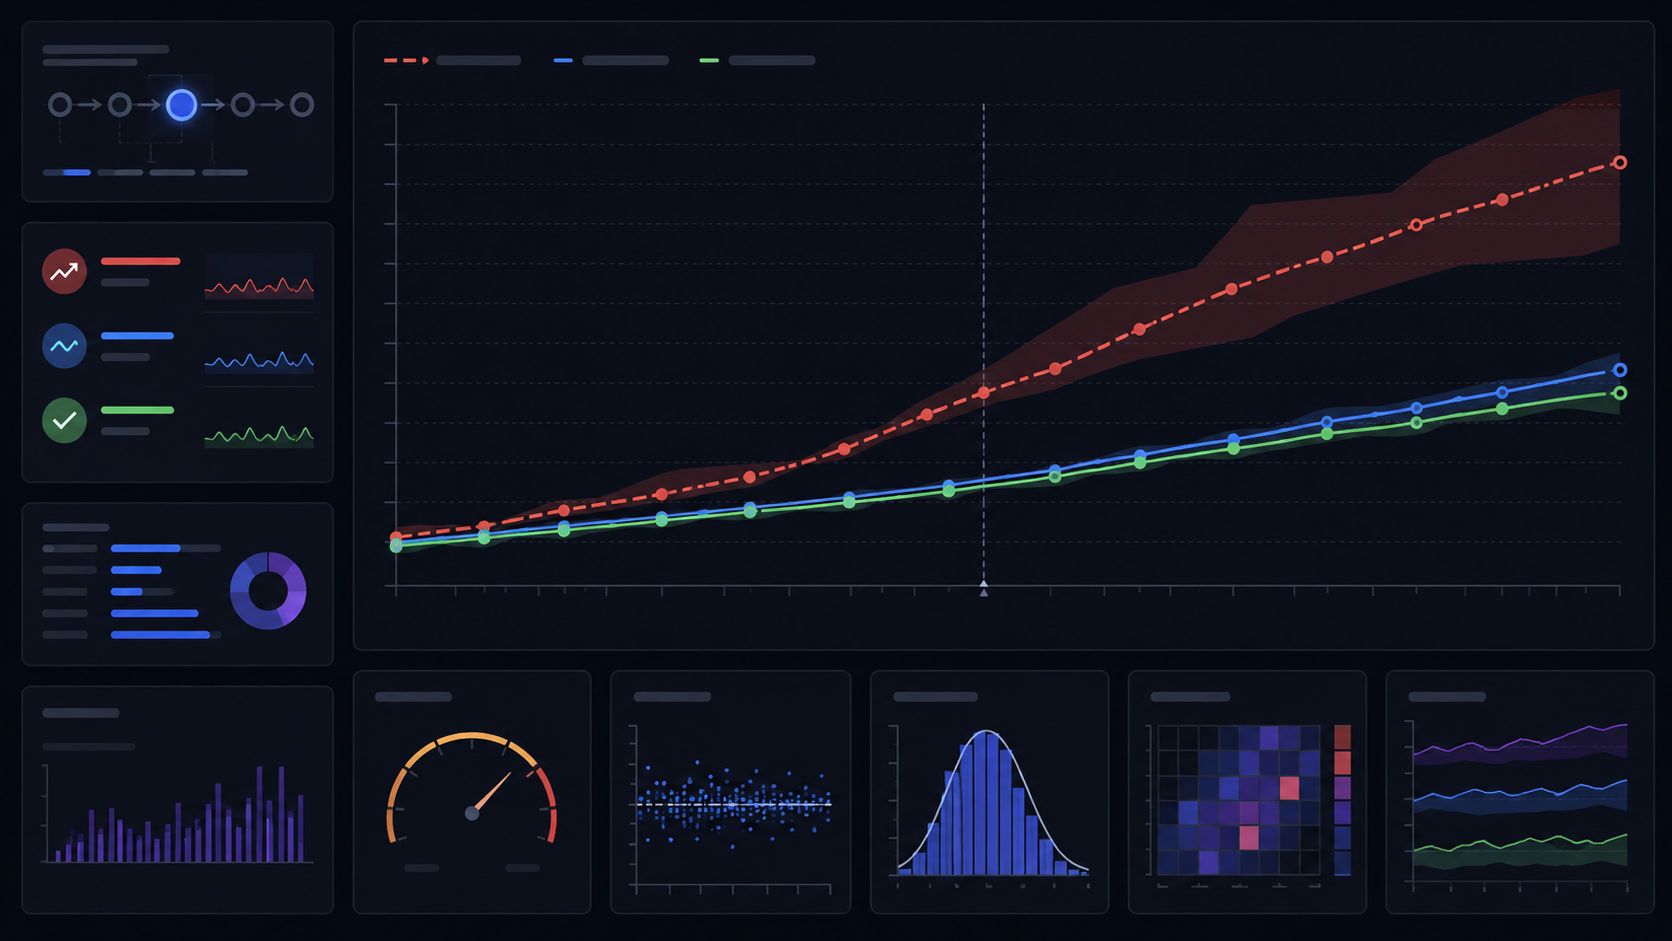
- Application Metrics dashboard는 AI 제안 공식이 실제 파일을 예측보다 최대 83% 크게 만들었고 bitrate 공식은 약 5% 오차에 머문 것을 보여 줬다.
- AI가 생성한 코드도 사용자 결과와 직접 연결된 production telemetry로 정확성을 검증해야 한다.
- 생성된 정량 로직에 predicted/actual metric과 오차 예산을 추가하고 대표 fixture로 rollout 전에 검증한다.
무슨 일이 있었나
그럴듯했지만 틀린 공식
영상 변환 도구는 사용자가 encoding을 기다리기 전에 출력 크기를 예측해야 했다. AI assistant가 제안한 첫 estimator는 source size에 target height와 source height의 비율을 곱했다. 해상도가 관련 있어 보였지만 bitrate encoding에서는 초당 bit 수와 duration이 대략적인 파일 크기를 결정한다는 핵심을 놓쳤다.
Sentry Application Metrics는 actual size와 estimated size의 비율을 기록했다. dashboard에서 이전 공식의 평균은 1.57이었고 최악의 값은 1.83이었다. 출력이 예고한 값보다 최대 83% 컸다는 의미다. bitrate 기반 계산으로 교체하자 평균은 0.97이 됐고 표본의 transcode 결과는 약 5% 범위에 들어왔다.
AI 코드의 테스트가 되는 telemetry
숫자 metric은 sampling되지 않으며 estimator, source format, destination format, conversion mode로 그룹화할 수 있다. 주 오류뿐 아니라 copy mode가 약 16% 높게 예측하고 GIF가 약 9% 높게 유지되는 패턴도 드러났다. 이런 관찰은 개선 backlog의 우선순위로 바로 전환할 수 있다.
교훈은 AI 코드를 쓰지 말라는 것이 아니라 생성 결과를 정확성의 증거로 간주하지 말라는 것이다. 정량 로직에는 invariant와 대표 fixture를 정의하고 예측과 실제 결과를 함께 기록하며 오차 비율에 alert를 걸어야 한다. Production observability가 잘못된 가정을 사용자 신뢰 저하 전에 잡는 feedback loop가 된다.
표본이 적을 때는 평균만 보지 말고 최대값과 분포를 함께 확인해야 한다. estimator basis 같은 속성을 기록하면 새 공식과 이전 공식을 같은 workload에서 비교할 수 있다. error budget을 넘으면 보수적인 계산이나 이전 버전으로 전환하는 안전장치도 유용하다.
관련 글
참고 자료
개발자가 주목해야 하는 이유
AI가 생성한 코드도 사용자 결과와 직접 연결된 production telemetry로 정확성을 검증해야 한다.
권장 조치
- 1생성된 정량 로직에 predicted/actual metric과 오차 예산을 추가하고 대표 fixture로 rollout 전에 검증한다.