빠른 요약
- Google Cloud는 Dataflow 기반 데이터 처리에 생성형 AI를 결합할 때 비용 효율성을 함께 고려해야 한다는 문제를 제시한다. 개발팀은 모델 호출 단가만 비교하기보다 입력 선별, 중복 처리, 재시도, 결과 검증을 포함한 전체 워크플로를 측정해야 한다.
- GenAI 워크로드의 비용은 데이터량뿐 아니라 파이프라인이 추론을 호출하는 방식에 따라 달라진다. 전체 경로를 계측하면 불필요한 호출을 찾고, 확장 전에 경제성과 운영 안정성을 검증할 수 있다.
- 대표 GenAI 워크플로 하나를 선정해 추론 도달률, 재시도, 유효 결과 수, 결과당 비용의 기준선을 만든 뒤 한 번에 하나의 제어 변수만 최적화한다.
무슨 일이 있었나
데이터 파이프라인에 생성형 AI를 추가하면 콘텐츠 보강과 변환 같은 작업을 자동화할 수 있다. 그러나 입력 레코드마다 추론이 실행되는 구조라면 데이터 증가가 곧 비용과 처리 지연의 증가로 이어질 수 있다.
Google Cloud의 Dataflow 기반 비용 효율적 GenAI 워크플로 글은 이 운영 문제를 핵심 주제로 삼는다. 제공된 크롤 레코드에는 구체적인 가격, 벤치마크, 구성 예시가 없으므로 이를 추정하기보다는 확인 가능한 주제에서 실무 설계 원칙을 도출하는 편이 안전하다.
어떤 비용을 한데 봐야 하는가?
추론 호출 비용은 눈에 잘 띄지만 전체 비용의 전부는 아니다. 입력을 읽고 변환하며 결과를 저장하는 데이터 처리 과정, 실패한 작업과 재시도, 중간 산출물 역시 워크플로 운영량을 늘린다.
비용 구조를 파악할 때는 데이터 처리, 모델 추론, 실패와 재처리에서 생기는 운영 오버헤드로 나눠 볼 수 있다. 이는 Google Cloud의 과금 공식이 아니라 엔지니어링 팀이 통제 지점을 찾기 위한 분석 틀이다.
- 입력 선택: 모든 레코드가 생성형 AI 처리를 필요로 하는가?
- 중복 작업: 같은 데이터나 변경되지 않은 데이터가 다시 처리되는가?
- 요청 크기: 작업과 무관한 컨텍스트가 포함되는가?
- 재시도: 일시적 오류가 추론 호출을 반복적으로 증폭하는가?
- 결과 저장: 중간 결과와 최종 결과를 모두 보존해야 하는가?
이렇게 분리하면 모델 호출을 줄였지만 전처리나 재처리 비용이 늘어나는 식의 부분 최적화를 피하기 쉽다.
추론 전후에 어떤 제어 단계를 둘 것인가?
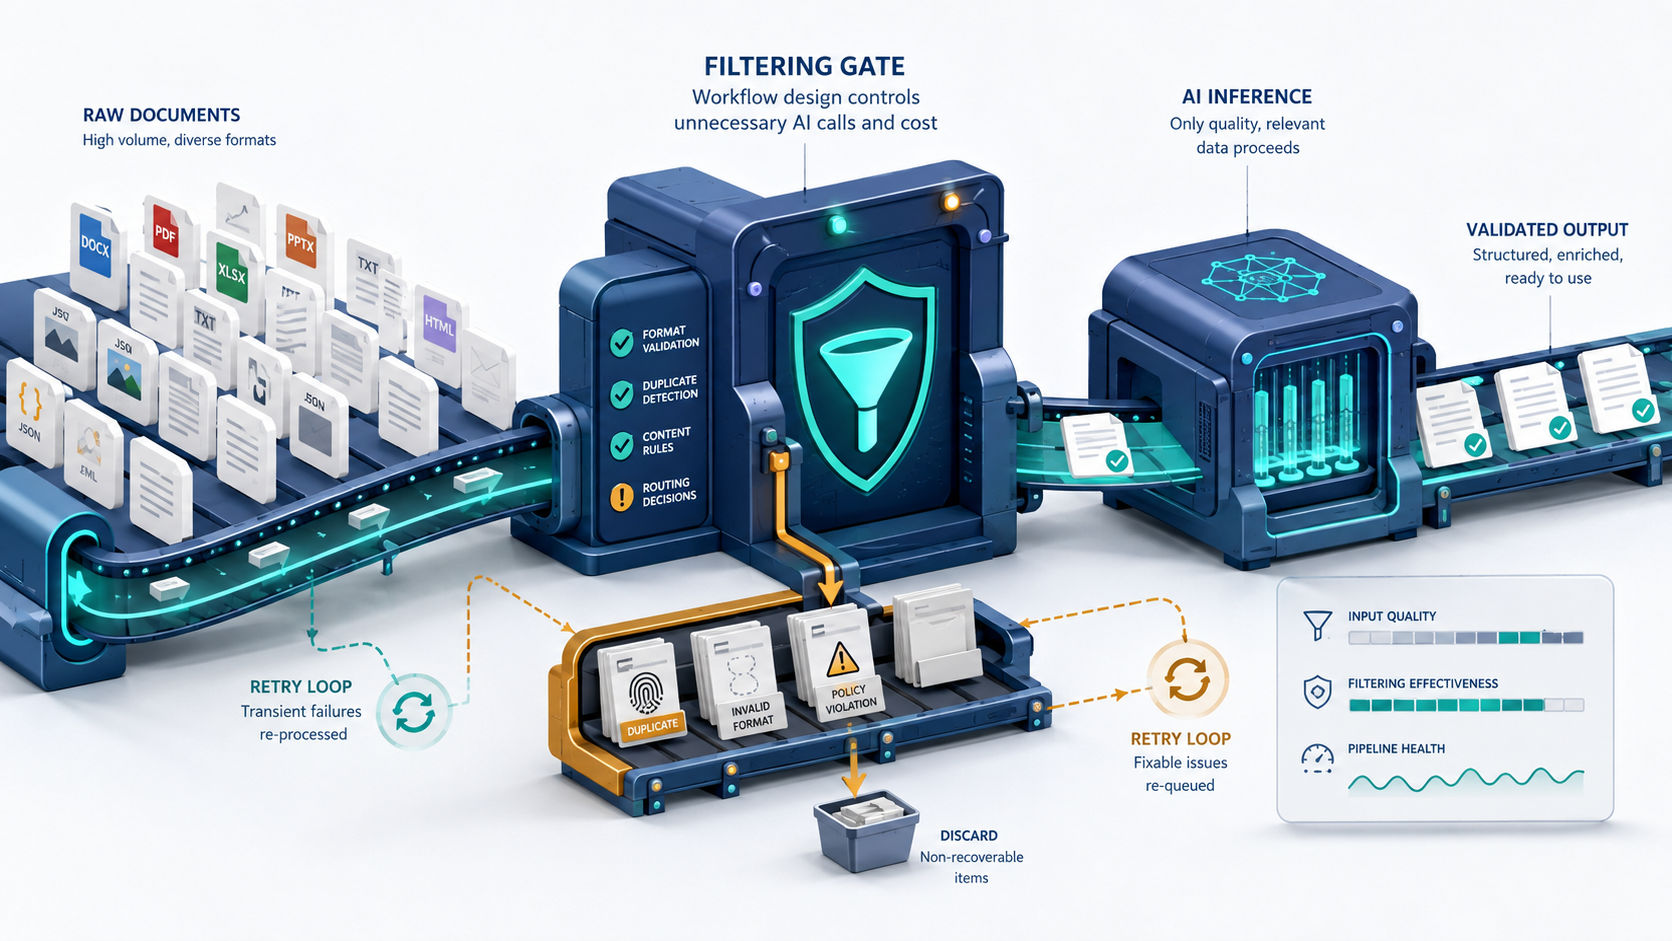
비용을 좌우하는 첫 번째 설계 결정은 어떤 입력을 추론 단계까지 보낼지 정하는 것이다. 유효성 검사, 중복 제거, 정규화, 작업 유형별 라우팅을 앞단에 두면 가치가 없는 요청을 줄일 수 있다.
추론 이후에는 요청 성공과 업무적으로 유효한 결과를 구분해야 한다. 호출 자체가 완료됐더라도 결과가 애플리케이션의 형식이나 품질 조건을 충족하지 못할 수 있으므로 검증, 격리, 대체 처리 기준이 필요하다.
개념적인 처리 순서는 수집, 검증, 중복 제거, 라우팅, 추론, 결과 검증, 필요한 데이터 저장으로 정리할 수 있다. 이 순서는 특정 Dataflow 기능이나 템플릿을 설명하는 것이 아니라 일반적인 워크플로 설계 권고다.
비용 최적화 전에 무엇을 측정해야 하는가?
기준선 없이 최적화하면 비용이 줄어든 이유와 단순한 트래픽 변화를 구분하기 어렵다. 입력 건수, 추론까지 도달한 비율, 성공률, 재시도 횟수, 처리 시간, 검증을 통과한 결과 수를 함께 기록하는 것이 좋다.
총비용만 보는 대신 유효 결과 한 건당 비용을 계산하면 시스템의 경제성을 더 명확히 판단할 수 있다. 예를 들어 성공적으로 보강된 문서 한 건을 단위로 삼으면, 지출 증가가 유용한 처리량 증가 때문인지 낭비 때문인지 구별하기 쉬워진다.
데이터 파이프라인의 관측성과 모델 서빙의 관측성을 분리해서 운영해서도 안 된다. 프로덕션 AI를 위한 GPU 및 모델 서빙 최적화에서 다루는 운영 관점은 추론 계층까지 연결된 지표를 설계할 때 참고할 수 있다.
프로덕션 확대 전에는 어떻게 검증할까?
먼저 실제 트래픽 특성을 반영한 제한된 데이터로 실행하고 예상 처리량, 실패율, 결과 조건을 문서화해야 한다. 입력 필터나 재시도 정책처럼 하나의 변수만 바꿔 결과를 비교하면 어떤 변경이 비용과 안정성에 영향을 줬는지 파악하기 쉽다.
- 측정 가능한 성공 조건이 있는 사용 사례 하나를 선택한다.
- 추론 전후의 변환과 저장 단계를 모두 도식화한다.
- 실험의 트래픽 및 비용 상한을 정한다.
- 필터링 비율, 호출 수, 검증 실패, 재시도를 연속된 흐름으로 추적한다.
- 유효 결과당 비용과 오류 동작을 확인한 뒤 단계적으로 확장한다.
운영 단계에서는 구성 변경 권한, 승인 절차, 감사 가능성도 중요해진다. 관리형 Control Plane 설계의 원칙은 기술 스택이 다르더라도 변경 통제 관점에서 참고할 만하다. 플랫폼이 팀의 안전한 실험을 방해하지 않도록 개발자 경험을 플랫폼 엔지니어링 계층으로 보는 접근도 함께 고려할 수 있다.
결론
- GenAI 비용은 모델 호출이 아니라 전체 데이터 경로를 기준으로 평가해야 한다.
- 추론 전 필터링과 중복 제거를 측정 가능한 제어 지점으로 설계해야 한다.
- 총지출과 함께 유효 결과 한 건당 비용을 추적해야 한다.
- 재시도와 실패 동작을 검증한 후 제한된 실험에서 단계적으로 확장해야 한다.
관련 글
- 프로덕션 AI를 위한 DevOps: GPU와 모델 서빙 최적화
- Ansible Automation Orchestrator: 관리형 Control Plane 설계
- Red Hat의 새 DevOps 방향을 잇는 계층, 개발자 경험
참고 자료
News, tips, and inspiration to accelerate your digital transformation
개발자가 주목해야 하는 이유
GenAI 워크로드의 비용은 데이터량뿐 아니라 파이프라인이 추론을 호출하는 방식에 따라 달라진다. 전체 경로를 계측하면 불필요한 호출을 찾고, 확장 전에 경제성과 운영 안정성을 검증할 수 있다.
권장 조치
- 1대표 GenAI 워크플로 하나를 선정해 추론 도달률, 재시도, 유효 결과 수, 결과당 비용의 기준선을 만든 뒤 한 번에 하나의 제어 변수만 최적화한다.