빠른 요약
- DeepSeek를 포함해 성능과 비용 경쟁력을 갖춘 모델도 그 자체만으로는 프로덕션급 시스템이 아니다. 신뢰성은 도구 라우팅, 컨텍스트와 메모리, 상태 복구, 평가, 관측성, 권한, 안전 가드레일, 추론 서빙으로 구성된 하니스에서 나온다.
- 모델 선택은 비용과 품질에 영향을 주지만, 시스템을 안전하게 운영하고 의미 있게 측정하며 실패 후 복구할 수 있는지는 하니스가 결정한다. 팀은 토큰 가격이나 벤치마크 점수만이 아니라 워크플로 전체 수명주기를 평가해야 한다.
- 2주 안에 한 워크플로를 대상으로 최소 게이트웨이를 구현하세요. 요청 단위 trace, 토큰·도구 호출 한도, 최소 권한 capability, 쓰기 작업 전 체크포인트, 도구 장애와 프롬프트 인젝션을 포함한 평가 스위트를 갖추십시오. 그다음에야 성공 결과당 비용으로 DeepSeek와 대안을 비교해야 합니다.
무슨 일이 있었나
성능이 좋고 경제성이 있는 오픈 모델은 AI 제품의 유용한 구성 요소가 될 수 있다. 그러나 모델 하나만으로 프로덕션급 시스템이 만들어지지는 않는다. 모델이 정보를 검색하고, 도구를 호출하며, 고객 데이터에 접근하고, 중단된 작업을 재개하거나, 사업상 결과를 낳는 출력을 생성해야 한다면 실제 품질은 모델을 둘러싼 시스템, 즉 하니스에 달려 있다.
이 글의 편집상 논지: DeepSeek를 비롯한 어떤 모델이든, 모델의 성능과 경제성은 하니스가 라우팅, 컨텍스트, 메모리, 상태 복구, 평가, 관측성, 권한, 안전 가드레일, 추론 서빙을 제공할 때에만 운영상의 가치가 된다. 이는 아키텍처에 관한 결론이며, DeepSeek가 특정 하니스를 만들었거나 사용하거나 지지했다는 주장이 아니다.
출처가 확인하는 사실과 이 글의 해석
출처로 확인된 사실: Vercel의 보고서는 8월에 Vercel 플랫폼에서 DeepSeek의 볼륨이 Google을 넘어섰고 토큰당 비용이 13.6% 하락했다고 말한다. 이 글은 그 흐름을 오픈 웨이트 모델의 더 큰 사용량 및 더 복잡한 사용 사례와 연결한다. 제공된 vLLM 가이드는 에이전트 추론의 서빙과 확장을 다룬다. Meta는 다단계 랭킹 아키텍처 사례를 공개했으며, GEM 학습 작업이 LLM 규모 광고 파운데이션 모델의 학습 효율을 두 배로 높였다고 밝혔다.
편집상 해석: 이 신호들은 특정 모델, 공급자, 아키텍처가 모든 워크로드에 맞는다는 것을 입증하지 않는다. 다만 트래픽과 자동화가 늘어날수록 비용, 지연 시간, 신뢰성, 위험은 API 호출 하나에 머물지 않으며 공용 하니스를 통해 관리해야 한다는 더 제한적인 운영 결론을 뒷받침한다.
AI 시스템에서 하니스란 무엇인가
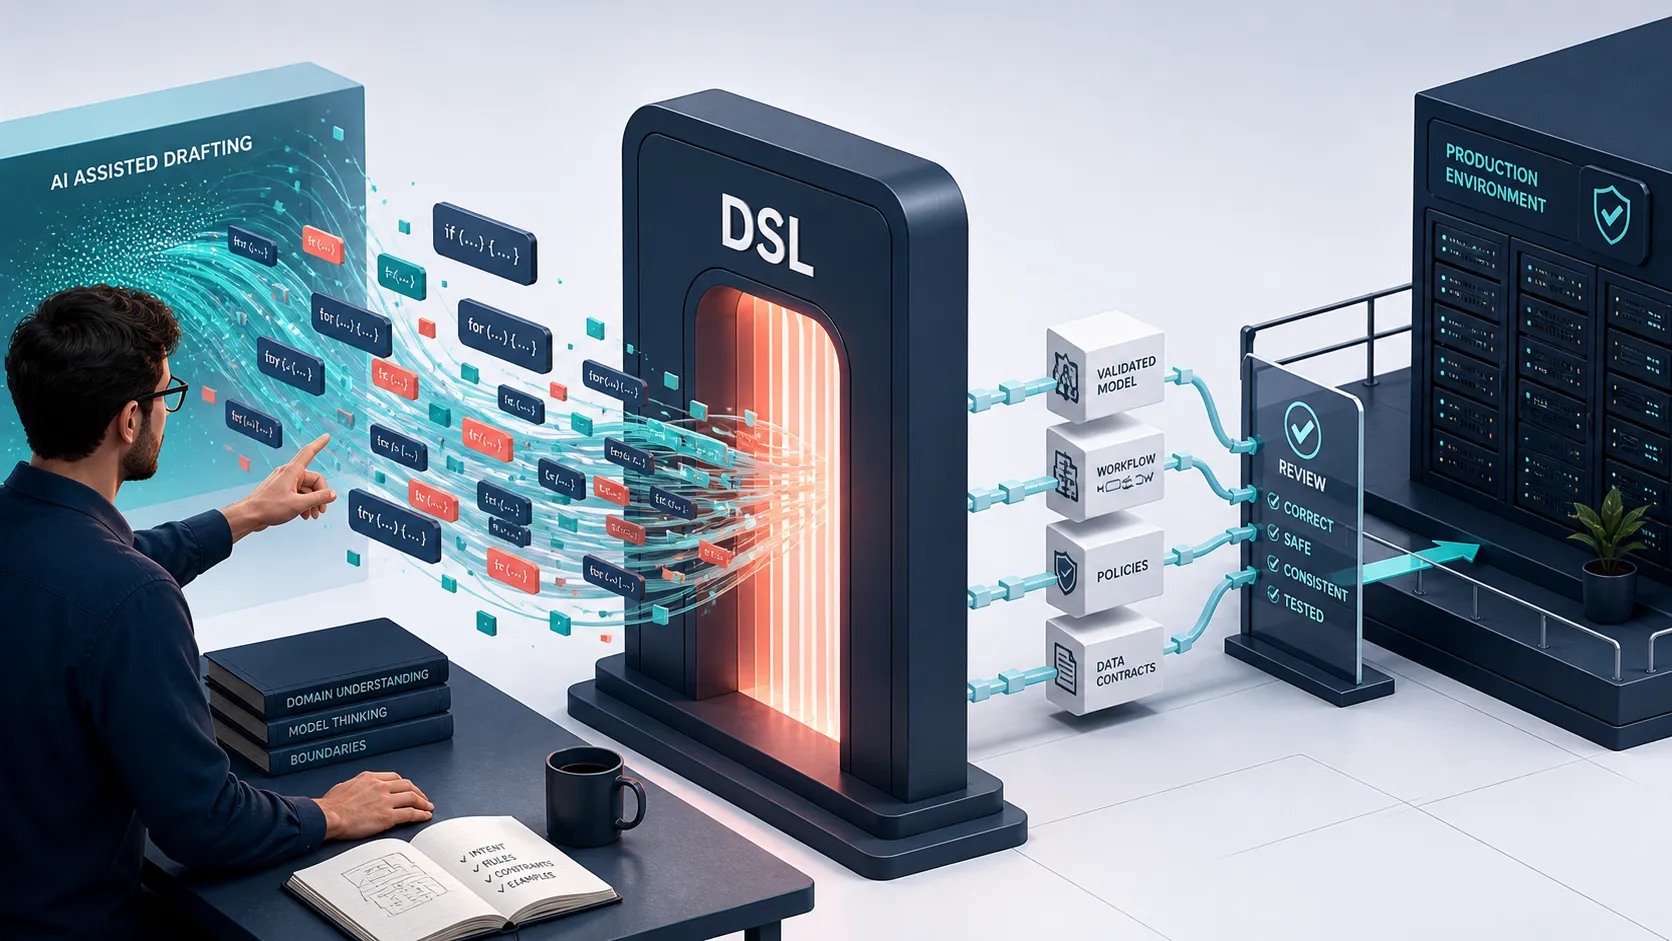
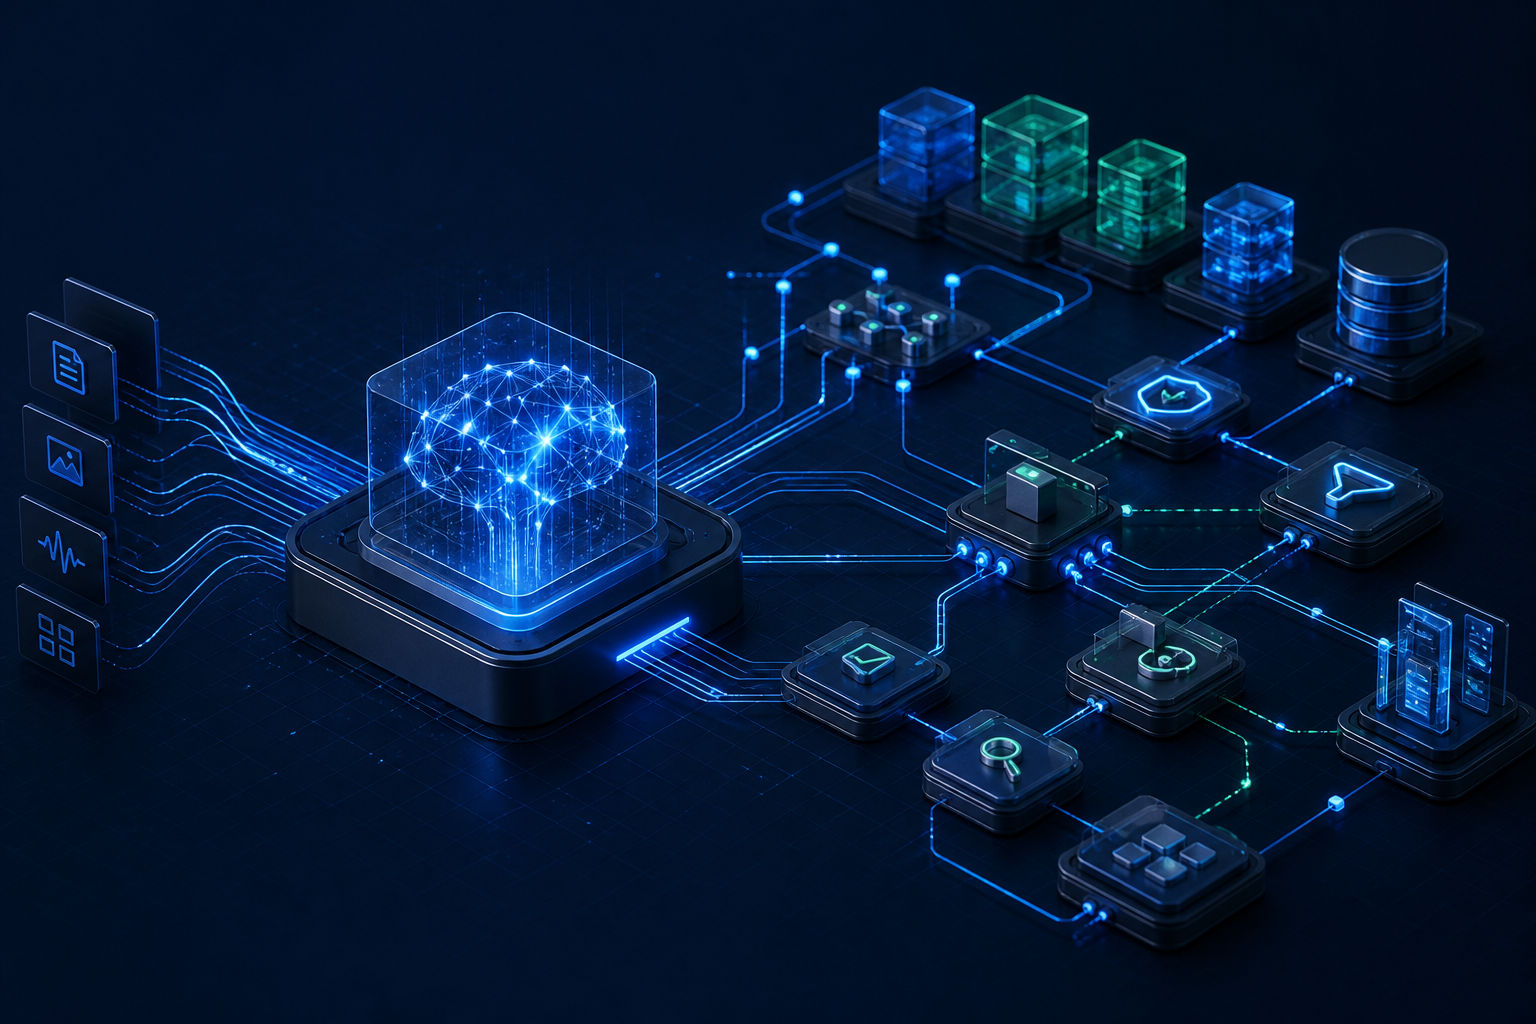
하니스는 확률적인 모델 출력을 경계가 있고 상태를 가지며 테스트 가능한 프로세스로 바꾸는 소프트웨어 및 운영 장치의 집합이다. 더 긴 프롬프트, 특정 에이전트 프레임워크 하나, 또는 자체 호스팅과 같은 뜻이 아니다. 하니스는 어떤 모델 API나 자체 호스팅 엔드포인트의 앞뒤와 주변에 놓일 수 있다.
이는 단순히 프롬프트만 조정하기보다 하니스를 구축하자는 Pulumi의 주장과 맞닿아 있다. 실제 엔지니어링 환경에서는 지침, hook, skill, 도구, 피드백 루프가 결과를 크게 바꿀 수 있다. 프로덕션에서는 한 단계 더 나아가야 한다. 하니스는 모델이 추론하는 방식뿐 아니라 시스템이 권한을 부여하고, 측정하고, 재시도하며, 안전하게 실패하는 방식도 통제해야 한다.
모델을 프로덕션급으로 만드는 여덟 가지 역량
1. 모델 및 도구 라우팅
모든 요청에 같은 모델이나 같은 수준의 접근 권한이 필요한 것은 아니다. 하니스는 먼저 작업을 분류해야 한다. 단순 질의, 구조화된 추출, 문서 요약, 다단계 추론, 도구를 통한 실행이 그 예다. 그다음 알맞은 모델, 프롬프트 템플릿, 토큰 한도, 도구 집합, 동기 또는 비동기 실행 방식을 선택할 수 있다.
이는 모델 경제성 신호에서 도출한 아키텍처 해석이지 DeepSeek에만 적용되는 처방이 아니다. Vercel 보고서는 모델 구성과 볼륨이 빠르게 움직일 수 있음을 보여준다. 라우팅 계층은 제품을 하나의 실행 경로에 영구적으로 묶지 않고 통제된 실험을 가능하게 한다.
2. 규율 있는 컨텍스트와 메모리
유용한 컨텍스트는 모든 이력을 프롬프트에 넣는 것이 아니다. 하니스는 어떤 데이터 소스가 허용되는지, 어떤 사실이 최신인지, 무엇을 인용해야 하는지, 어떤 개인정보를 제거하거나 마스킹해야 하는지를 결정해야 한다. 장기 메모리에는 보존 정책, 테넌트 경계, 만료 규칙, 삭제 메커니즘이 필요하다.
실무에서는 최소한 세 층을 분리하는 것이 좋다. 짧은 수명의 세션 상태, 검증된 작업 사실, 명시적 동의를 받은 사용자 메모리다. 각 항목에는 출처, 생성 시각, 접근 정책이 있어야 한다. 그렇지 않으면 시스템은 모델이 어떤 정보를 알게 된 이유를 설명하거나 사용자 간 데이터 유출을 막기 어렵다.
3. 상태, 체크포인트, 복구
다단계 에이전트는 timeout, 도구 장애, 데이터 변경, 사람의 승인 요구를 만난다. 하니스는 목표, 정규화된 입력, 이미 호출한 도구, 중간 결과, 프롬프트 및 모델 버전, 승인된 결정을 내구성 있는 식별자 아래에 저장해야 한다.
가능한 곳에서는 도구 작업을 idempotent하게 설계한다. 재시도할 때 시스템은 어떤 작업이 이미 끝났는지 알아야 중복 이메일을 보내거나 중복 지원 티켓을 만들거나 중복 거래를 실행하지 않는다. 외부에 영향을 주는 작업은 실행 전 체크포인트를 두고, 모델이 행동을 제안한 뒤 확인을 요구하는 것이 기본적인 보호책이다.
4. 배포 전후의 평가
일반 벤치마크는 실제 작업에 대한 평가를 대체하지 못한다. 정상 입력, 누락 데이터, 모호한 요청, 프롬프트 인젝션, 도구 장애, 고위험 사례를 포함한 대표 테스트 세트를 만든다. 출력 품질뿐 아니라 프로세스 행동도 평가해야 한다. 모델이 올바른 도구를 골랐는지, 권한을 지켰는지, 올바른 출처를 인용했는지, 적절한 시점에 멈췄는지를 확인한다.
모델, 프롬프트, 도구 스키마, 검색 인덱스, 서빙 구성을 바꿀 때 평가는 다시 실행되어야 한다. 지표는 토큰 소비만이 아니라 성공한 워크플로 결과와 연결되어야 한다. 더 저렴한 모델도 재시도, 더 강한 모델로의 escalation, 수동 수정이 늘어난다면 실제로는 더 비쌀 수 있다.
5. 관측성과 감사 가능성
각 실행에는 엔드투엔드 trace가 필요하다. 모델 버전, 공급자 또는 엔드포인트, 입력·출력 토큰, 큐 및 추론 지연 시간, 도구 호출, 재시도, 캐시 적중, 오류, 추정 비용, 최종 결과가 포함되어야 한다. 로그는 불필요한 시크릿과 개인정보 보존을 피하면서도 허가된 범위에서 사고를 재구성할 충분한 근거를 남겨야 한다.
p50·p95 지연 시간, 도구 오류율, 워크플로 완료율, 성공 결과당 비용, 사람 개입률, 안전 거부율을 추적한다. AI 지출 총액만 보는 대시보드로는 어떤 파이프라인이 재시도나 권한 오류를 일으키는지 알 수 없다.
6. 최소 권한과 승인
모델에 광범위한 자격 증명을 직접 제공해서는 안 된다. 하니스는 테넌트, 작업, 데이터셋, 시간으로 제한된 단기 capability를 발급해야 한다. 도구 게이트웨이는 외부 시스템을 호출하기 전에 입력 스키마를 검증하고, allowlist를 적용하며, rate limit을 두고, 감사 이벤트를 기록해야 한다.
읽기 작업, 되돌릴 수 있는 쓰기, 되돌릴 수 없는 행동을 명확히 구분해야 한다. 송금, 데이터 삭제, 접근 권한 변경, 대량 메시지 발송에는 모델의 결론과 독립적인 승인 정책이 필요하다.
7. 안전 가드레일과 이탈 경로
가드레일은 system prompt의 문장 하나여서는 안 된다. 입력 필터링, 권한 인식 데이터 검색, 도구 파라미터 검증, 금지된 콘텐츠나 행동의 탐지, 비용과 시간 한도, 사람에게 escalation하거나 기능을 축소하는 경로 등 여러 계층에 있어야 한다.
어떤 가드레일도 위험을 완전히 없애지는 못한다. 프롬프트 인젝션, 신뢰할 수 없는 검색 자료, 모델 행동의 변동성은 여전히 설계 전제로 남는다. 따라서 견고한 시스템은 모델이 모든 요청을 완료하도록 강제하기보다 거부하고, 미루고, 검증을 요청할 수 있어야 한다.
8. 추론 서빙과 운영 신뢰성
서빙은 부하 상황에서도 정책을 집행할 수 있는지를 결정한다. 동시성 한도, 큐, batching, caching, timeout, rate limit, fallback, 버전 rollout, 테넌트 격리가 여기에 포함된다. vLLM은 LLM 서빙에서 흔히 논의되는 선택지 중 하나이며, 제공된 출처는 이를 에이전트 추론 확장 맥락에서 다룬다. 그렇다고 자체 호스팅이 항상 관리형 API보다 낫다는 뜻은 아니다.
총소유비용을 비교해야 한다. GPU, 유휴 용량, 전력, 냉각, 보안, 온콜 인력, 복구 목표를 API와 GPU 가격만큼 함께 고려해야 한다. 이러한 물리적 제약은 GPU, 전력, 냉각, 데이터센터를 AI 인프라 의사결정으로 보는 글에서 더 다룬다.
실용적인 구현 경로
- 좁은 워크플로 하나를 고른다: 가치가 분명하고 입력이 정의되어 있으며 결과를 측정할 수 있는 작업을 우선한다.
- 워크플로 계약을 정의한다: 입력, 구조화된 출력, 허용 도구, 토큰 및 시간 한도, 중지 조건, 승인 책임자를 명시한다.
- 공용 게이트웨이를 만든다: 인증, 라우팅, quota, logging, redaction, retry 정책을 각 애플리케이션에 흩어 넣지 말고 하나의 통제 지점에 둔다.
- 모든 구성 요소를 버전 관리한다: 모델, 프롬프트, 도구 스키마, 검색 코퍼스, 정책이 trace와 평가에 나타나야 한다.
- 단계적으로 배포한다: shadow 또는 canary 실행으로 기존 프로세스와 비교한 뒤, 미리 정한 품질·비용·안전 임계값을 충족할 때만 확대한다.
- 장애를 연습한다: 느린 공급자, 실패하는 도구, 소진된 quota, 오염된 검색 데이터, 중단된 워크플로를 시험한다.
플랫폼 엔지니어링 원칙은 그대로 적용된다. 개발자 경험과 플랫폼 엔지니어링에 관한 글에서 다루듯 logging, quota, secret management, 관측성을 갖춘 paved path를 제공해야 한다. 그래야 팀이 통제를 복제하지 않고도 모델이나 서빙 백엔드를 바꿀 수 있다.
이 논지의 한계
좋은 하니스가 부적합한 모델을 적합하게 만들지는 못한다. 모델이 특정 도메인 품질이 부족하거나, 중요한 형식을 지키지 못하거나, 규제 요구를 충족하지 못한다면 라우팅과 가드레일은 피해를 줄일 수 있을 뿐 빠진 기본 역량을 만들어 내지는 못한다.
하니스에도 비용이 있다. 지연 시간 증가, 운영 부담, 통합 복잡성, 추가 장애 지점이 생긴다. 작은 팀은 명확한 워크로드도 없이 대형 플랫폼을 먼저 만들 필요가 없다. 최소 게이트웨이, trace, 권한 한도, 평가 스위트로 시작하고, 측정 결과가 정당화할 때 장기 메모리, 멀티 모델 라우팅, 자체 호스팅을 더하면 된다.
결론: DeepSeek는 구성 요소로 평가하고, 하니스는 제품처럼 운영하라
제공된 근거는 DeepSeek가 변화하는 사용량과 토큰 비용의 흐름에서 주목할 요소임을 보여주지만, 보편적인 선택을 확정하지는 않는다. 프로덕션급의 질문은 단지 “어떤 모델이 더 저렴한가?”가 아니다. “시스템이 모델 기반 워크플로를 통제하고, 측정하고, 복구하고, 설명할 수 있는가?”이다.
DeepSeek든 다른 어떤 모델이든 답은 하니스에 달려 있다. 모델은 능력을 제공하고, 하니스는 그 능력을 허용 가능한 비용 한도, 신뢰성, 안전성 안에서 사용자에게 전달할 수 있는지를 결정한다.
출처
- Vercel: DeepSeek overtakes Google on volume, cost per token falls 13.6%
- freeCodeCamp: How to Scale LLM Inference for AI Agents Using vLLM
- Pulumi: Stop Tuning Prompts. Build a Harness.
- Lilian Weng: Harness Engineering for Self-Improvement
- Meta Engineering: From User Sequences to Scaling Laws
- Meta Engineering: GEM Training
- ByteVora: AI 인프라, GPU, 전력, 냉각, 데이터센터
개발자가 주목해야 하는 이유
모델 선택은 비용과 품질에 영향을 주지만, 시스템을 안전하게 운영하고 의미 있게 측정하며 실패 후 복구할 수 있는지는 하니스가 결정한다. 팀은 토큰 가격이나 벤치마크 점수만이 아니라 워크플로 전체 수명주기를 평가해야 한다.
권장 조치
- 12주 안에 한 워크플로를 대상으로 최소 게이트웨이를 구현하세요. 요청 단위 trace, 토큰·도구 호출 한도, 최소 권한 capability, 쓰기 작업 전 체크포인트, 도구 장애와 프롬프트 인젝션을 포함한 평가 스위트를 갖추십시오. 그다음에야 성공 결과당 비용으로 DeepSeek와 대안을 비교해야 합니다.