Tóm tắt nhanh
- Databricks nêu các use case AI_Functions trong data warehouse, trong khi AWS trình bày workflow không cần code cho dự đoán và BI. Hai hướng cho thấy đội ngũ có thể bắt đầu AI gần dữ liệu, nhưng cần phân biệt tác vụ AI trong SQL với vòng đời mô hình dự đoán.
- Đặt AI gần warehouse có thể giảm ma sát tích hợp, nhưng không nên đánh đồng việc gọi AI function với việc xây một hệ thống ML hoàn chỉnh.
- Phân loại use case hiện tại thành tác vụ warehouse, prediction có nhãn hoặc analytics; sau đó chọn một pilot nhỏ với outcome có thể đo.
Điều gì đã xảy ra
Low-code ML không chỉ có giao diện kéo thả. Databricks đang đưa AI_Functions vào data warehouse qua các use case được giới thiệu, còn AWS mô tả Canvas, Data Wrangler và Quick Sight như một workflow trực quan cho prediction và BI.
Cả hai đều hướng tới việc đưa AI đến gần nơi dữ liệu đã được quản lý. Nhưng chúng phù hợp với những lớp bài toán khác nhau, và kiến trúc tốt bắt đầu bằng việc phân biệt chúng.
Hai điểm khởi đầu, hai loại công việc
AI function trong warehouse gợi ý một cách nhúng tác vụ AI trực tiếp vào luồng dữ liệu và phân tích. Cách này có thể hữu ích khi công việc bắt đầu từ bảng dữ liệu và cần được lồng vào thao tác warehouse.
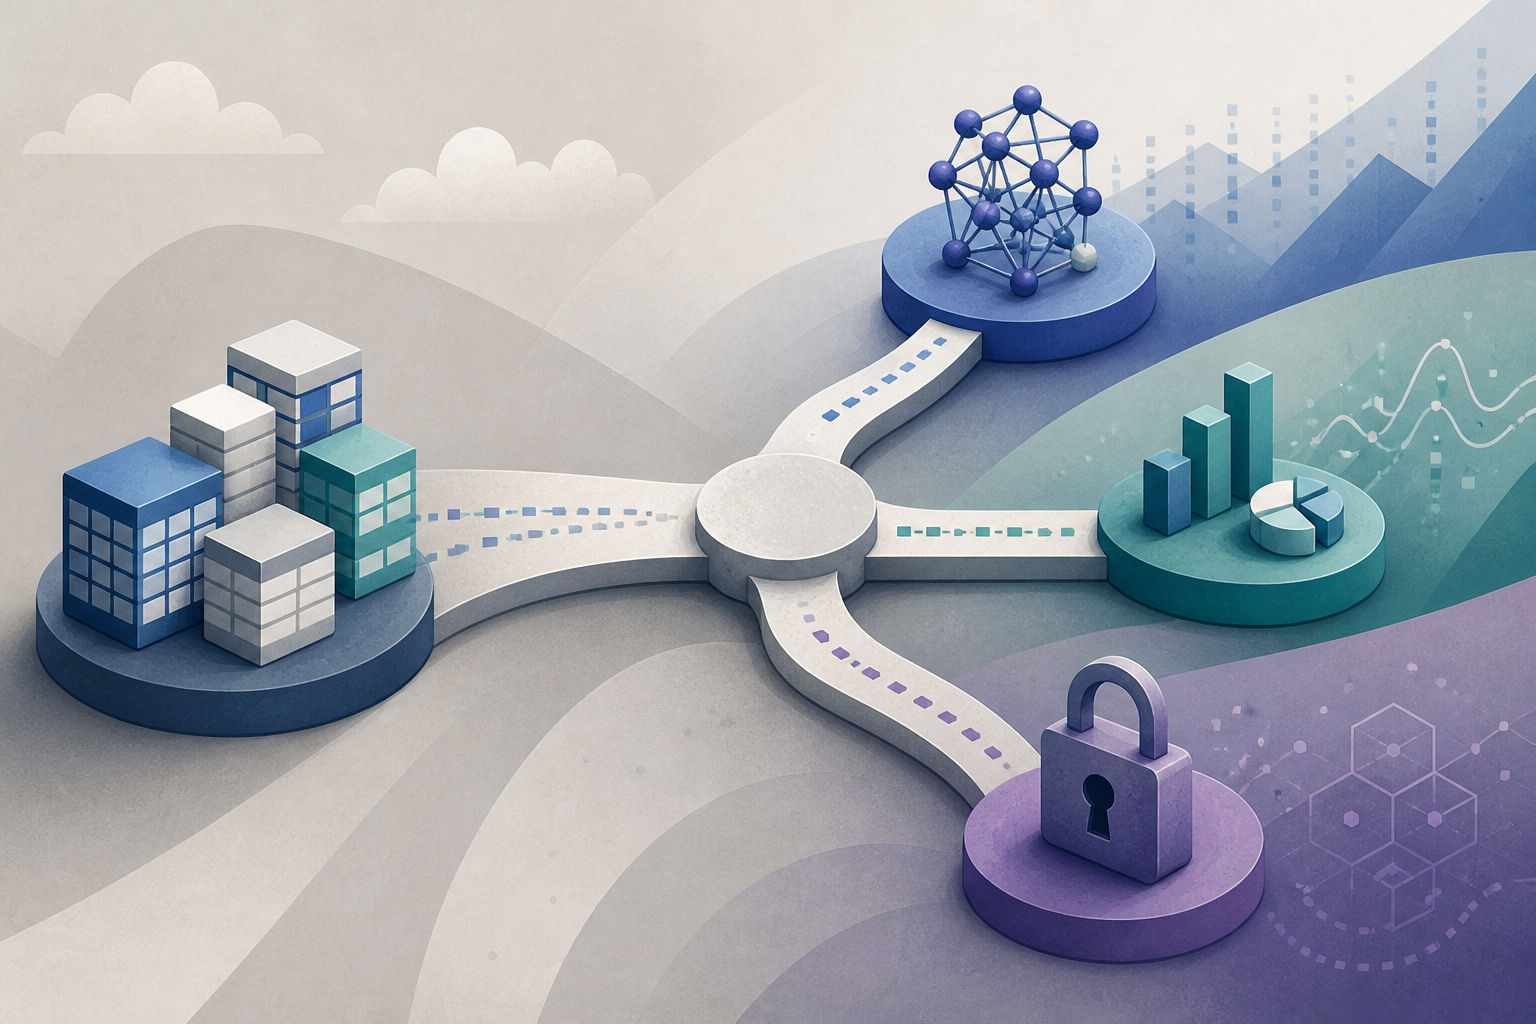
Workflow AWS tập trung rõ hơn vào prediction pipeline: kết nối Snowflake, chuẩn bị và join dữ liệu trong Data Wrangler, huấn luyện XGBoost trong Canvas, rồi đưa prediction sang Quick Sight. Đây là đường đi cho use case có nhãn và cần mô hình dự đoán.
Đừng gọi mọi thứ là machine learning
Một AI function có thể là thành phần hữu ích trong công việc dữ liệu, nhưng không tự động cung cấp nhãn, đánh giá, monitoring hay quy trình hành động sau prediction. Tương tự, một model Canvas không tự trở thành hệ thống vận hành chỉ vì kết quả được hiển thị trên dashboard.
Phân loại đúng vấn đề trước: đội ngũ cần biến đổi hoặc làm giàu dữ liệu, dự đoán một outcome đã định nghĩa, hay giúp người dùng hỏi dữ liệu? Mỗi mục tiêu cần tiêu chí đánh giá và ownership khác nhau.
Cách chọn thử nghiệm đầu tiên
| Nhu cầu | Điểm bắt đầu hợp lý |
|---|---|
| Tác vụ AI sát dữ liệu warehouse | Đánh giá AI Functions trong luồng dữ liệu |
| Dự đoán có nhãn lịch sử | Thử workflow Canvas và dữ liệu Snowflake |
| Khám phá kết quả cho stakeholder | Dashboard và natural-language BI |
Bảng này là khung quyết định, không phải so sánh tính năng. Hãy giữ pilot nhỏ, chọn một outcome có thể kiểm tra, và xác định chi phí vận hành trước khi mở rộng.
Kiến trúc tối giản vẫn cần đường thoát
Dù bắt đầu trong warehouse hay giao diện no-code, hãy lưu input, output, cấu hình và owner. Đồng thời xác định cách chuyển sang code hoặc pipeline riêng nếu nhu cầu về kiểm thử, tích hợp, độ trễ hay kiểm soát vượt quá khả năng của lớp low-code.
Trong 5 phút
- Databricks nêu AI_Functions trong warehouse; AWS nêu workflow trực quan cho prediction và BI.
- AI trong SQL và hệ thống dự đoán có vòng đời khác nhau.
- Chọn điểm khởi đầu theo loại công việc, không theo nhãn “AI”.
- Giữ artifact và chuẩn bị đường chuyển sang kiến trúc nhiều code hơn khi cần.
Nguồn tham khảo
- Build a no-code ML workflow with Snowflake, Amazon SageMaker Canvas and Amazon Quick – Part 1: Setting up your Snowflake environment
- Build a no-code ML workflow with Snowflake, Amazon SageMaker Canvas and Amazon Quick – Part 2: Data preparation and model building with Amazon SageMaker Canvas
- Build a no-code ML workflow with Snowflake, Amazon SageMaker Canvas and Amazon Quick – Part 3: Visualizing insights with Amazon Quick Sight
- How Databricks Feature Store serves features with sub-second freshness
- Using AI_Functions in Your Data Warehouse: Top Use Cases
Vì sao developer cần quan tâm
Đặt AI gần warehouse có thể giảm ma sát tích hợp, nhưng không nên đánh đồng việc gọi AI function với việc xây một hệ thống ML hoàn chỉnh.
Hành động đề xuất
- 1Phân loại use case hiện tại thành tác vụ warehouse, prediction có nhãn hoặc analytics; sau đó chọn một pilot nhỏ với outcome có thể đo.