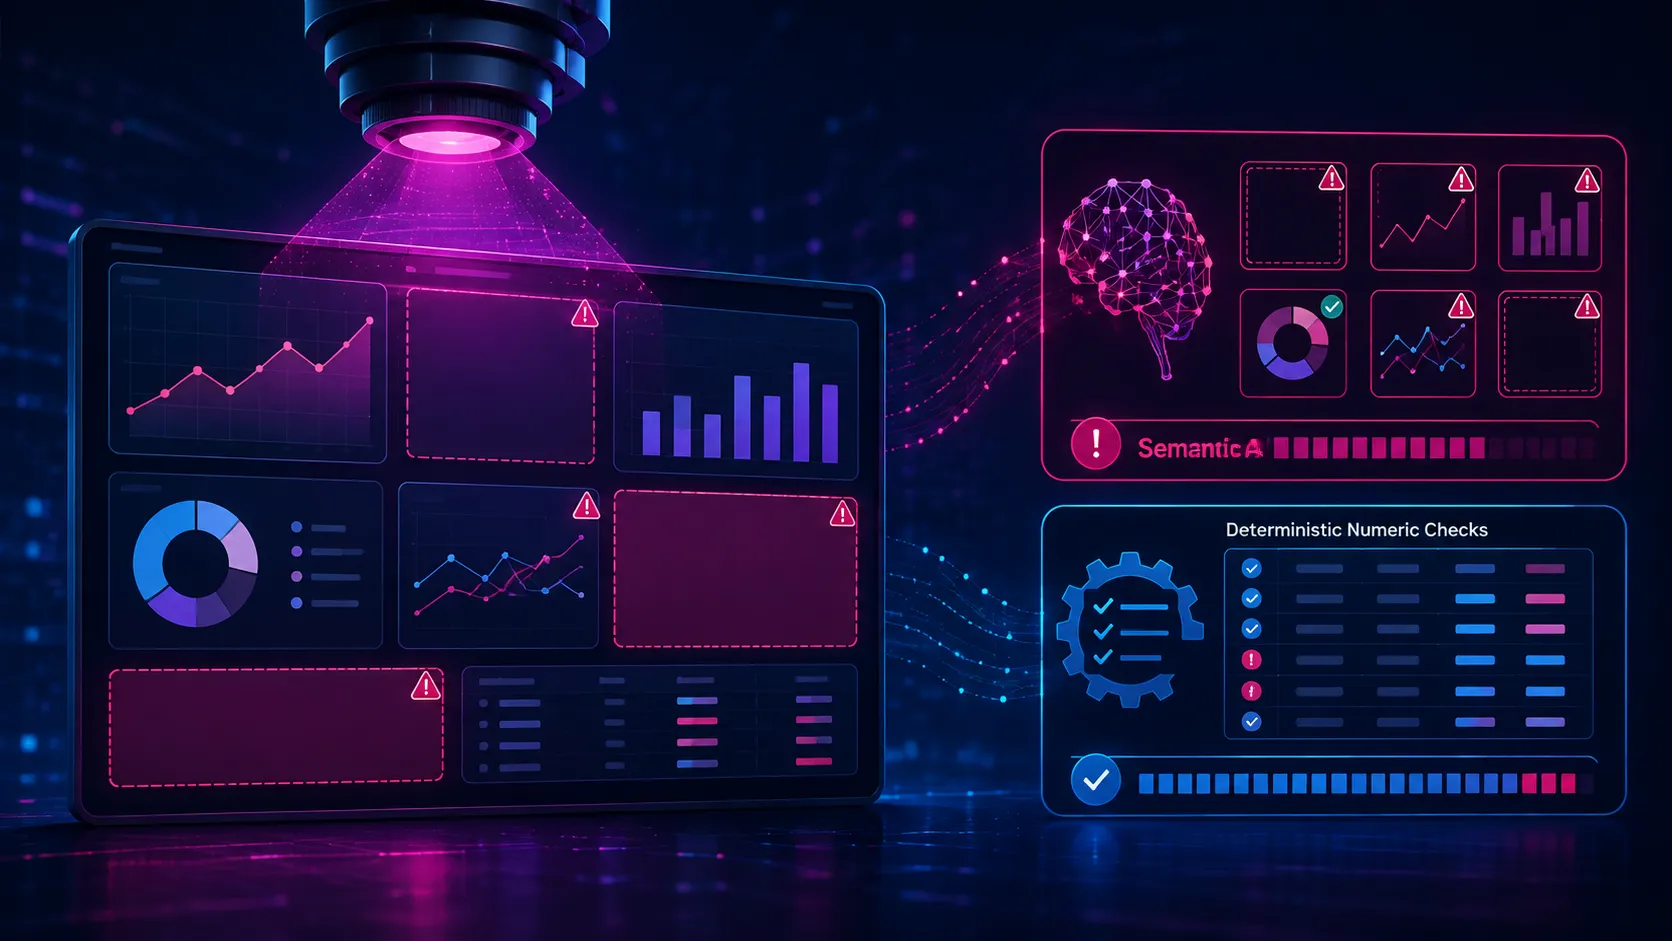
AWS xây pipeline validation lớp hiển thị, quét dashboard bằng ảnh và đối chiếu số liệu để giảm thời gian phát hiện lỗi từ tối đa 72 giờ xuống dưới một giờ.
Đang chuẩn bị bài viết bản địa hóa và thông tin nguồn.
Đã tuyển chọn, xác minh và đặt trong ngữ cảnh.

AWS xây pipeline validation lớp hiển thị, quét dashboard bằng ảnh và đối chiếu số liệu để giảm thời gian phát hiện lỗi từ tối đa 72 giờ xuống dưới một giờ.

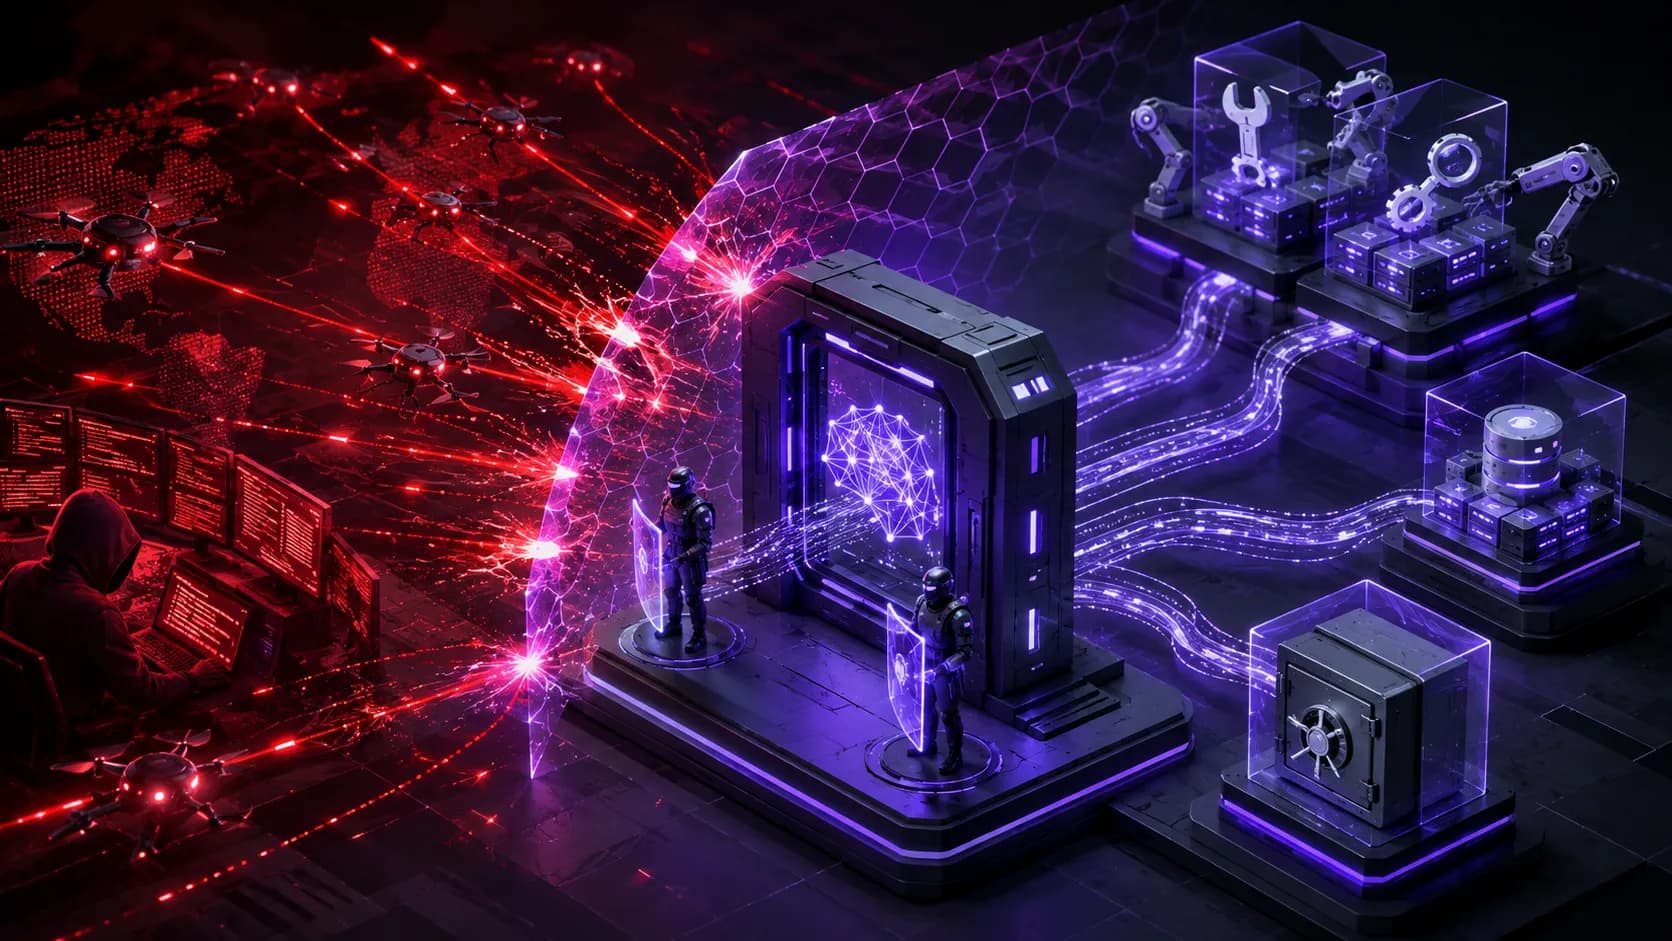
Kiến trúc AWS chuyển video đào tạo thành SOP, dùng RAG hướng dẫn xử lý ticket và ML dự báo rủi ro SLA trong một hệ thống vận hành thống nhất.

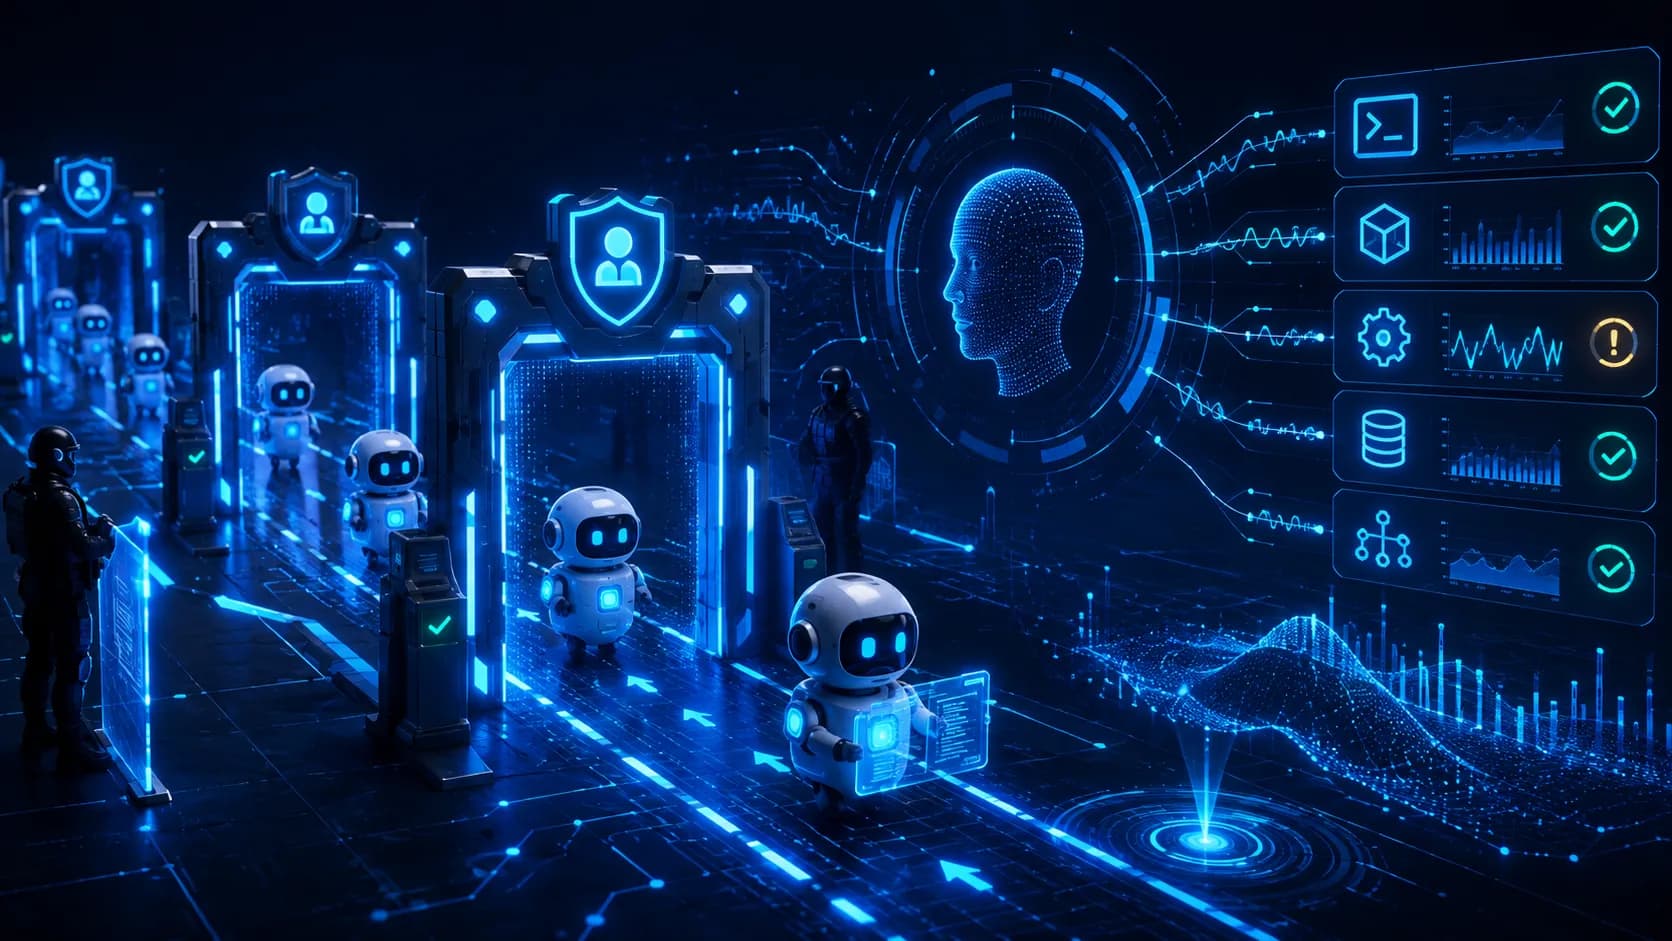
Wiz ghi nhận chiến dịch nhắm vào LiteLLM, MCP server và framework AI bằng RCE, blind prompt injection và đánh cắp credential trong bộ nhớ.

AWS đề xuất mở rộng các nền tảng zero trust, least privilege và defense in depth để kiểm soát agent tự chủ, xác suất và có khả năng hành động.

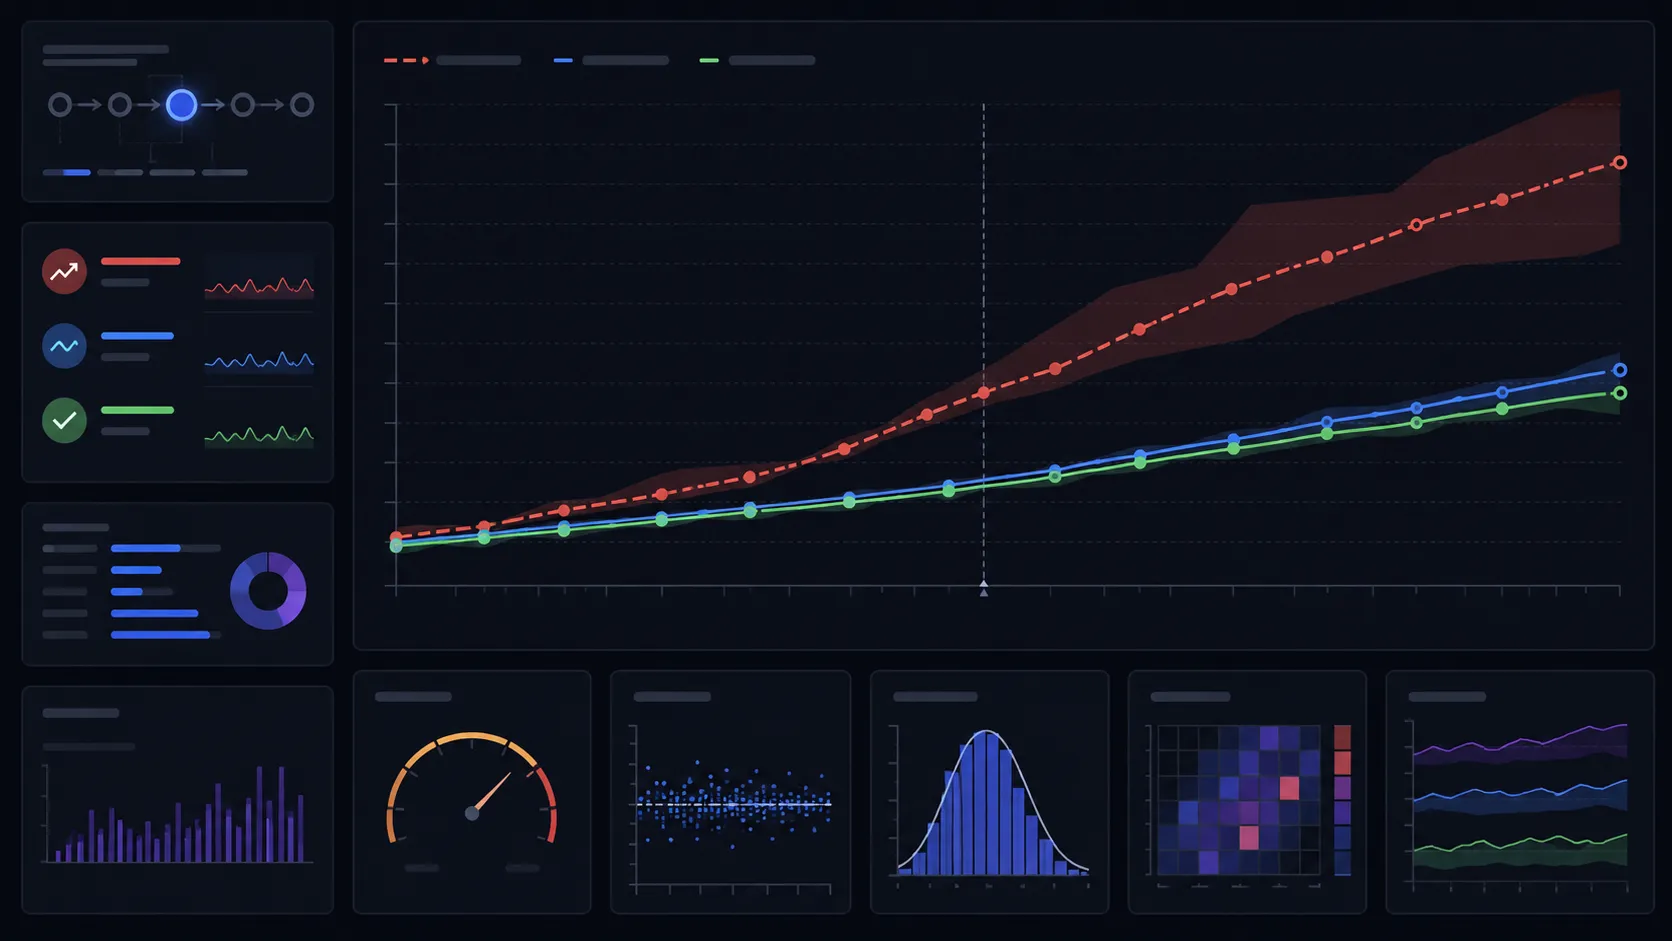
Một dashboard Application Metrics cho thấy công thức AI đề xuất làm file video thực tế lớn hơn dự đoán tới 83%, trong khi công thức bitrate mới sai lệch khoảng 5%.

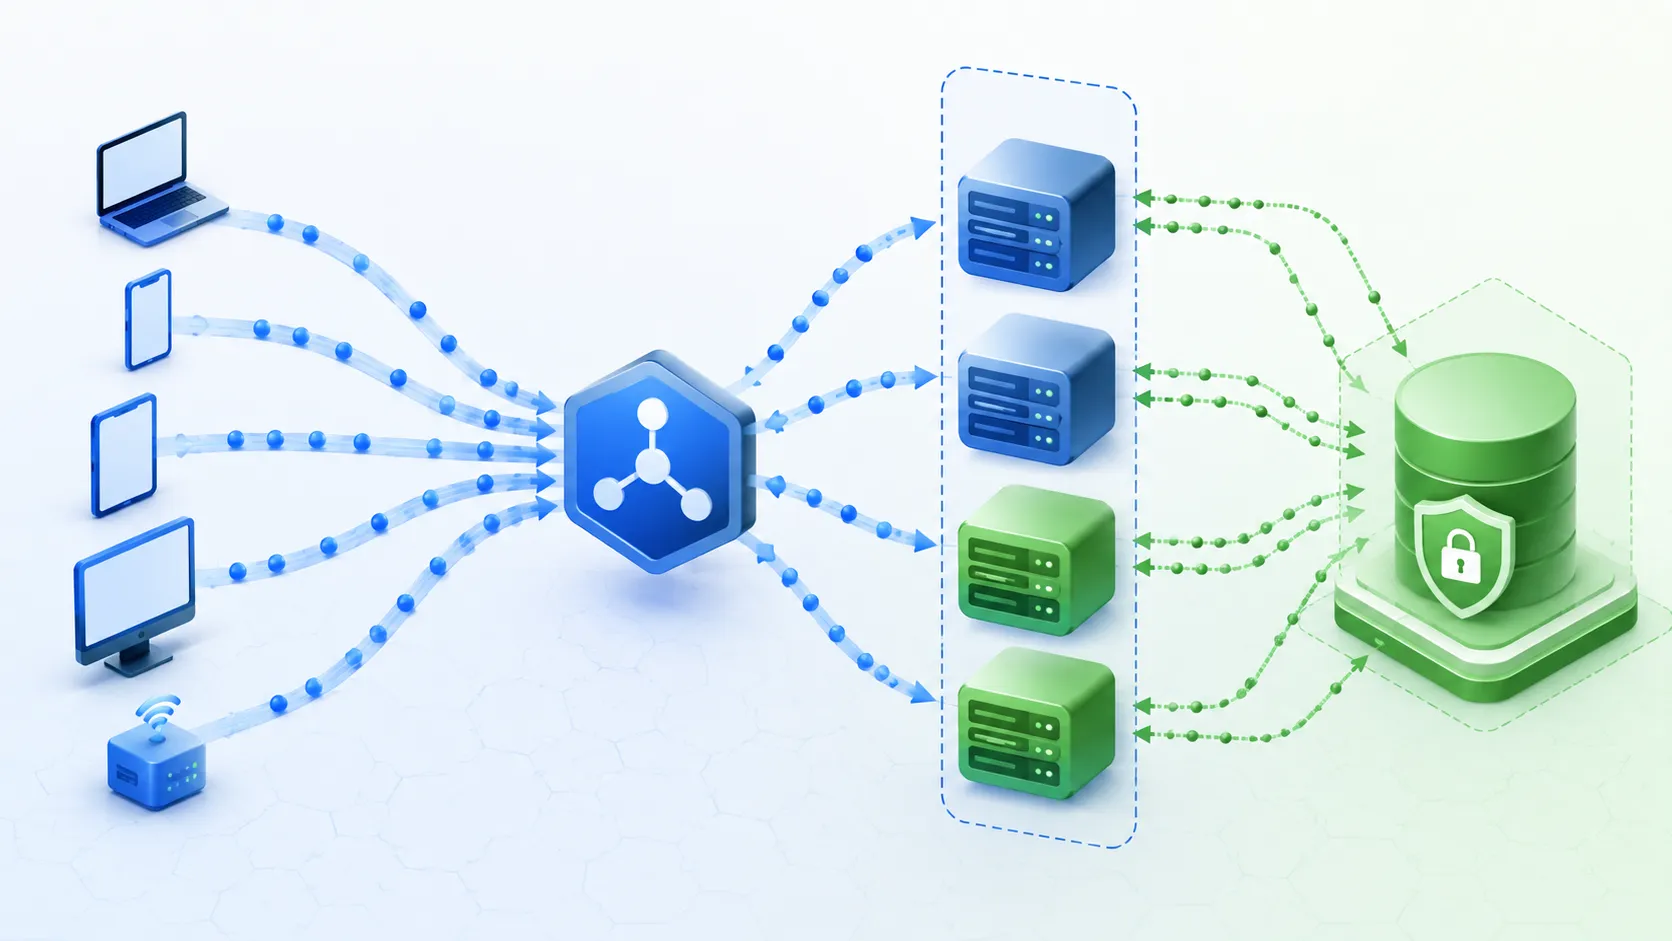
Đặc tả MCP 2026-07-28 loại bỏ handshake initialize và Mcp-Session-Id, đưa ngữ cảnh phiên vào từng request để server dễ mở rộng ngang hơn.

Bản tổng hợp tháng 9/2026 của Svelte tập trung các thay đổi mới trong hệ sinh thái framework và công cụ dành cho nhà phát triển.

Cloudflare thử nghiệm Cache Transcoding trong Pingora, nén tài nguyên đủ điều kiện bằng Zstandard trước khi lưu và giải nén khi phân phối.

Ba liên danh do SK Telecom, KT và Kakao dẫn dắt được chọn phát triển dịch vụ “AI cho mọi người” tại Hàn Quốc. Các bên dự kiến dùng tổng cộng 512 GPU NVIDIA B200 do chính phủ cung cấp để xây dựng chatbot và AI agent miễn phí trong năm.

KEPCO đang thảo luận với Samsung Electronics và SK Hynix về cơ chế cho doanh nghiệp tiêu thụ điện lớn trả trước tiền điện trong tương lai. Khoản tiền dự kiến được dùng để xây dựng lưới điện phục vụ bán dẫn, trung tâm dữ liệu AI và các ngành công nghệ cao, nhưng điều kiện cụ thể chưa được công bố.

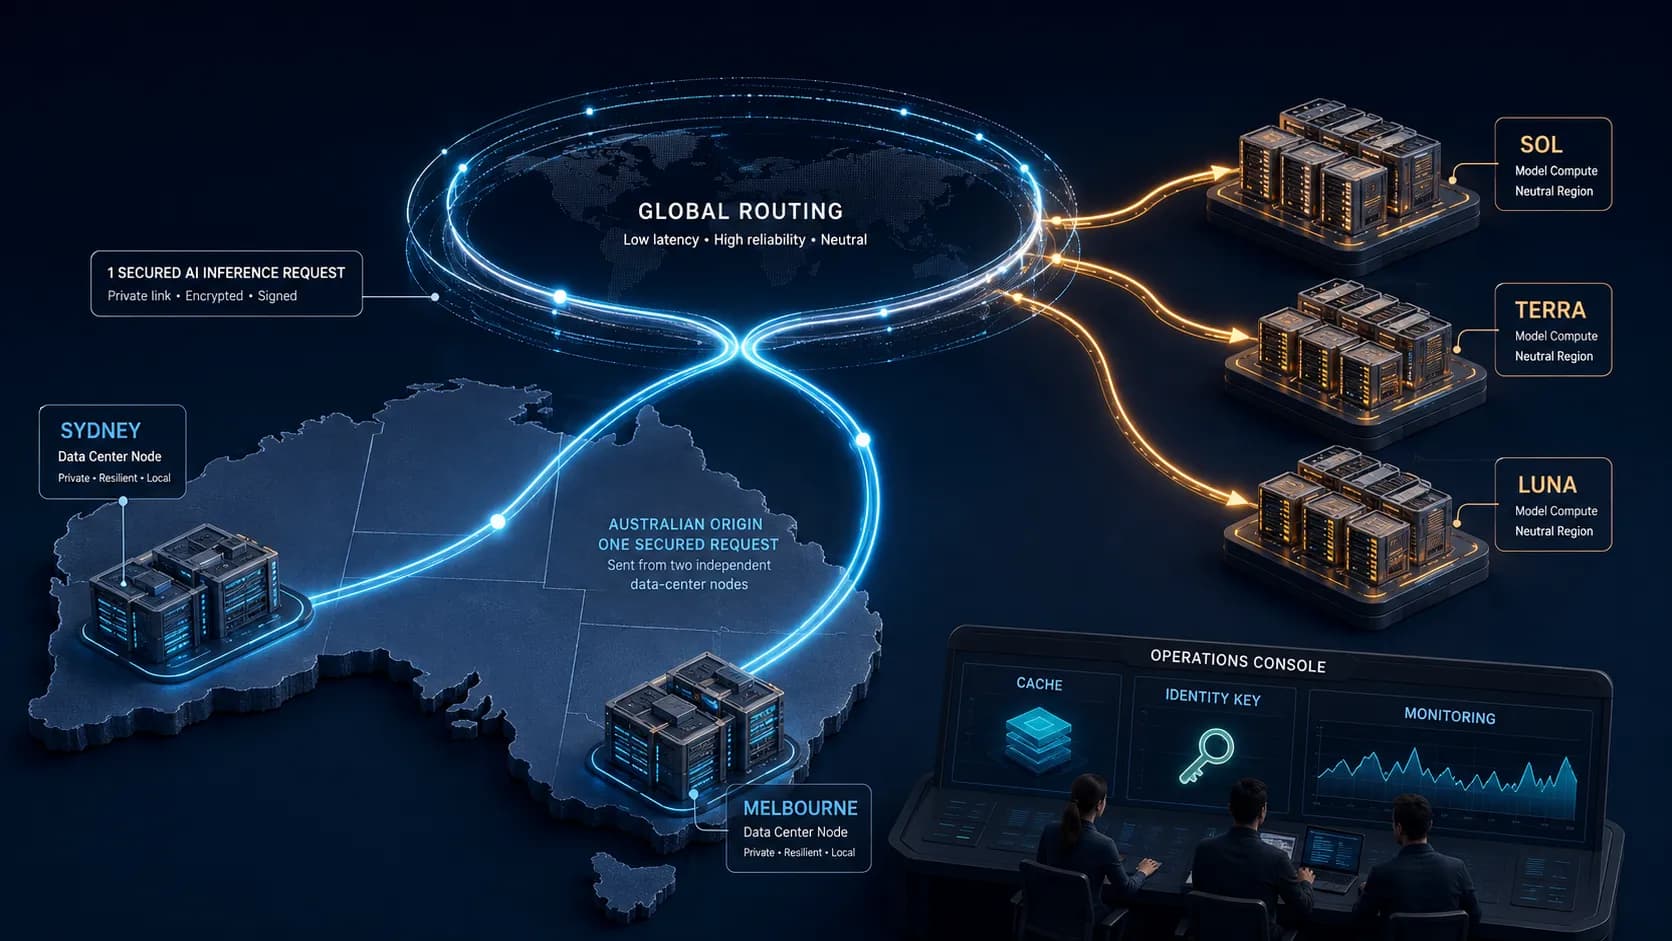
AWS cho biết các nhóm tại Australia có thể gọi OpenAI GPT-5.6 Sol, Terra và Luna trên Amazon Bedrock từ Sydney hoặc Melbourne bằng global cross-Region inference. Hướng dẫn cũng kết nối bốn phần của quy trình vận hành: gọi mô hình, prompt caching, xác thực Codex bằng OpenID Connect và giám sát qua CloudWatch.

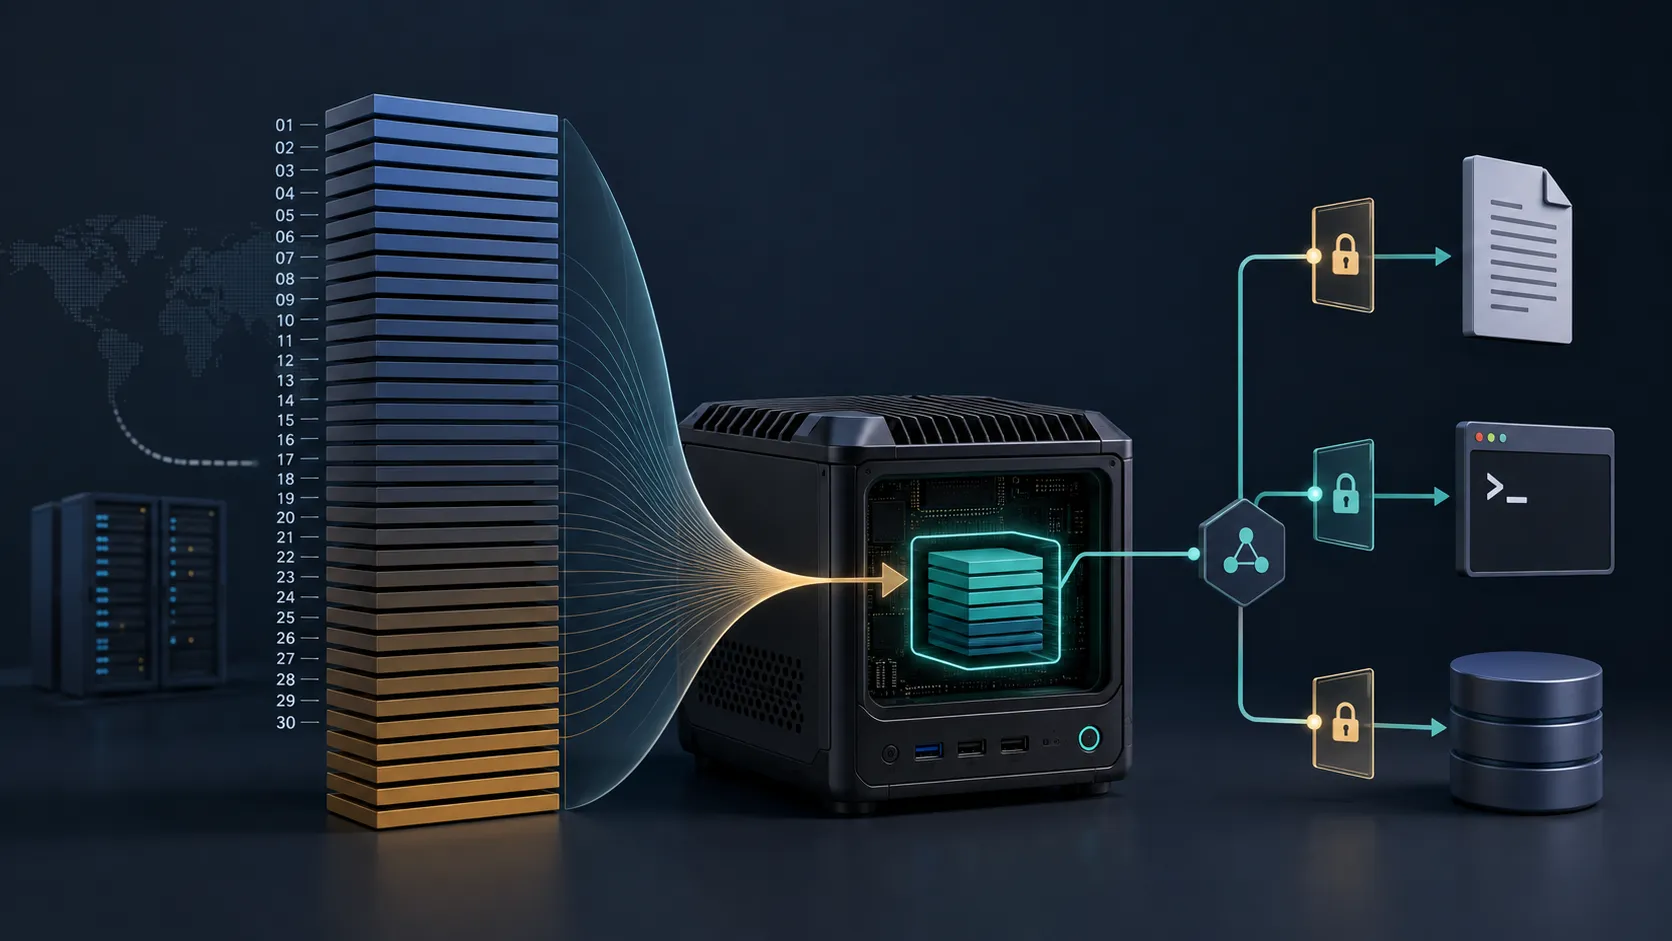
Meta đã giới thiệu Muse Glimmer, mô hình open-weight 30 tỷ tham số được chưng cất từ Muse Spark và hướng đến quy trình AI tác tử chạy trên thiết bị. Thông tin ban đầu đáng chú ý, nhưng chưa đủ để kết luận về hiệu năng, yêu cầu phần cứng hay mức độ sẵn sàng cho production.