빠른 요약
- 최근 LangSmith 업데이트는 AI 에이전트 엔지니어링의 중심이 모델 선택에서 평가, 이슈 탐지, 배포 전 테스트와 운영 제어로 이동하고 있음을 보여준다. 작업 환경, 에이전트 하네스, 교정 가능한 메모리 역시 프로덕션 스택의 중요한 요소로 부상하고 있다.
- 에이전트의 신뢰성은 모델뿐 아니라 이를 둘러싼 실행 시스템에 좌우된다. 개발팀은 동작을 측정하고 변경을 격리하며 상태를 관리하고, 프로덕션 장애를 재현 가능한 테스트로 전환해야 한다.
- 범위가 제한된 에이전트 워크플로 하나를 선정하고 실제 실패 사례로 회귀 테스트 세트를 만든 뒤, 프리뷰 테스트와 evaluator, 프로덕션 트레이싱을 시험하라.
무슨 일이 있었나
더 강력한 모델을 선택하는 것만으로는 AI 에이전트를 프로덕션에 안정적으로 배포하기 어렵다. 최근 LangSmith 관련 업데이트는 모델 바깥의 엔지니어링 계층, 즉 동작 평가, 변경 사항 프리뷰, 이슈 탐지와 상태 관리에 초점을 맞추고 있다.
이러한 발표가 에이전트 신뢰성 문제가 해결됐다는 증거는 아니다. 다만 업계의 관심이 프롬프트 중심 데모에서 변경과 실패를 측정하고 통제할 수 있는 운영 체계로 이동하고 있다는 신호로 볼 수 있다.
에이전트 툴체인에서 무엇이 달라지고 있나?
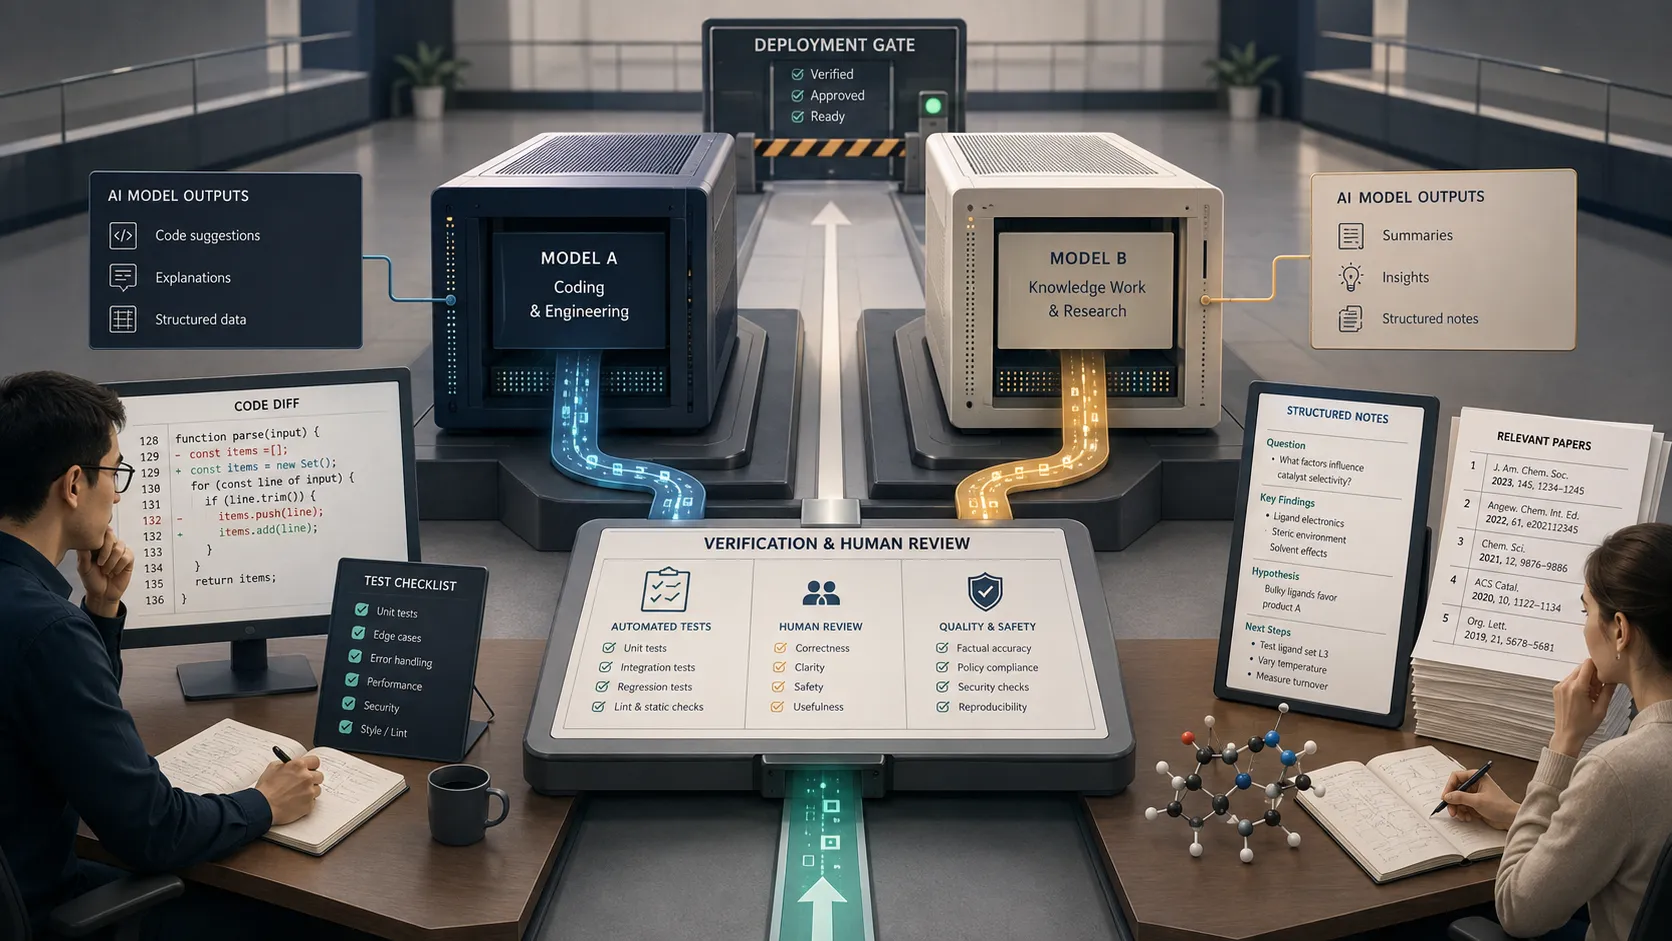
LangChain은 에이전트 수명 주기의 서로 다른 단계를 겨냥한 기능을 공개했다. LangSmith Preview Builds는 프로덕션 반영 전에 에이전트 변경 사항을 테스트하기 위한 기능으로, 실험 버전과 실제 사용자에게 제공되는 버전을 분리하는 데 초점을 둔다.
동작 평가 측면에서는 Perceived Error로 시작하는 Tuned Evaluators가 소개됐다. 고정된 출력 검증에만 의존하지 않고 사용자가 인식하는 오류에 가까운 문제를 찾으려는 접근이다. LangChain은 별도로 LangSmith Engine의 이슈 탐지 성능이 두 배 이상 개선됐다고 밝혔다. 이는 공급업체가 발표한 결과이며, 모든 워크로드에 그대로 적용되는 독립 벤치마크로 해석해서는 안 된다.
또 다른 사례는 Toyota North America가 deep agent와 LangSmith를 엔터프라이즈 AI에 활용한 과정을 다룬다. 제공된 공개 자료만으로 다른 조직의 성과까지 일반화할 수는 없다. 그러나 관측성과 평가가 개발 단계의 디버깅 도구를 넘어 기업 배포 인프라로 자리 잡고 있음을 보여주는 사례다.
왜 모델만으로 에이전트 시스템을 설명할 수 없나?
에이전트는 한 번의 답변만 생성하지 않는다. 상태를 입력받고, 도구를 고르고, 여러 단계를 실행하며, 결과를 관찰하고, 정보를 메모리에 기록할 수도 있다. 따라서 장애 원인은 모델뿐 아니라 프롬프트, 데이터, 권한, 작업 환경, 오케스트레이션 로직 또는 오래된 상태에 있을 수 있다.
에이전트 하네스는 모델을 둘러싼 실행 계층을 뜻한다. 지시문, 도구, 실행 루프, 제한 조건, 오류 처리와 관측성이 여기에 포함된다. 하네스의 중요성을 다룬 외부 보도는 이 계층이 중요한 차별화 요소가 되고 있다고 해석한다. 주목할 만한 관점이지만, 실제 효과는 각 팀의 작업과 운영 제약을 기준으로 검증해야 한다.
평가 환경도 같은 이유로 중요하다. LangChain은 에이전트 환경과 작업을 구축하는 방법을 설명하며, 에이전트가 행동할 수 있는 맥락의 중요성을 강조했다. 테스트 환경이 지나치게 단순하거나 프로덕션과 다르면 높은 평가 점수도 잘못된 확신을 줄 수 있다.
에이전트 Control Plane은 무엇을 측정해야 하나?
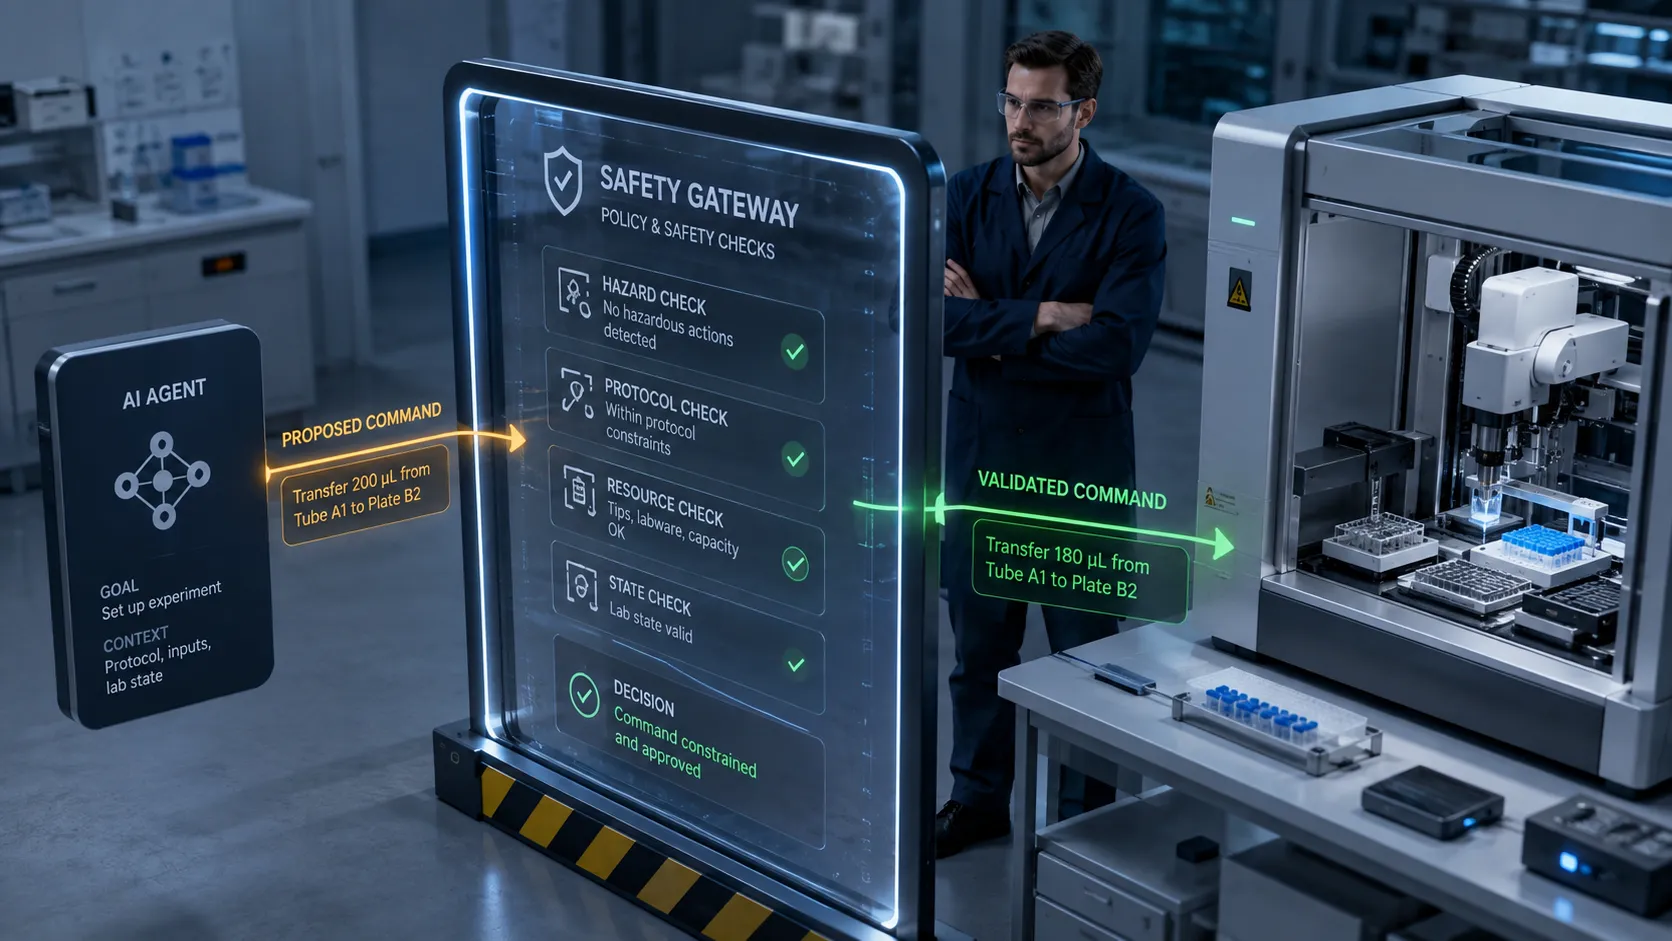
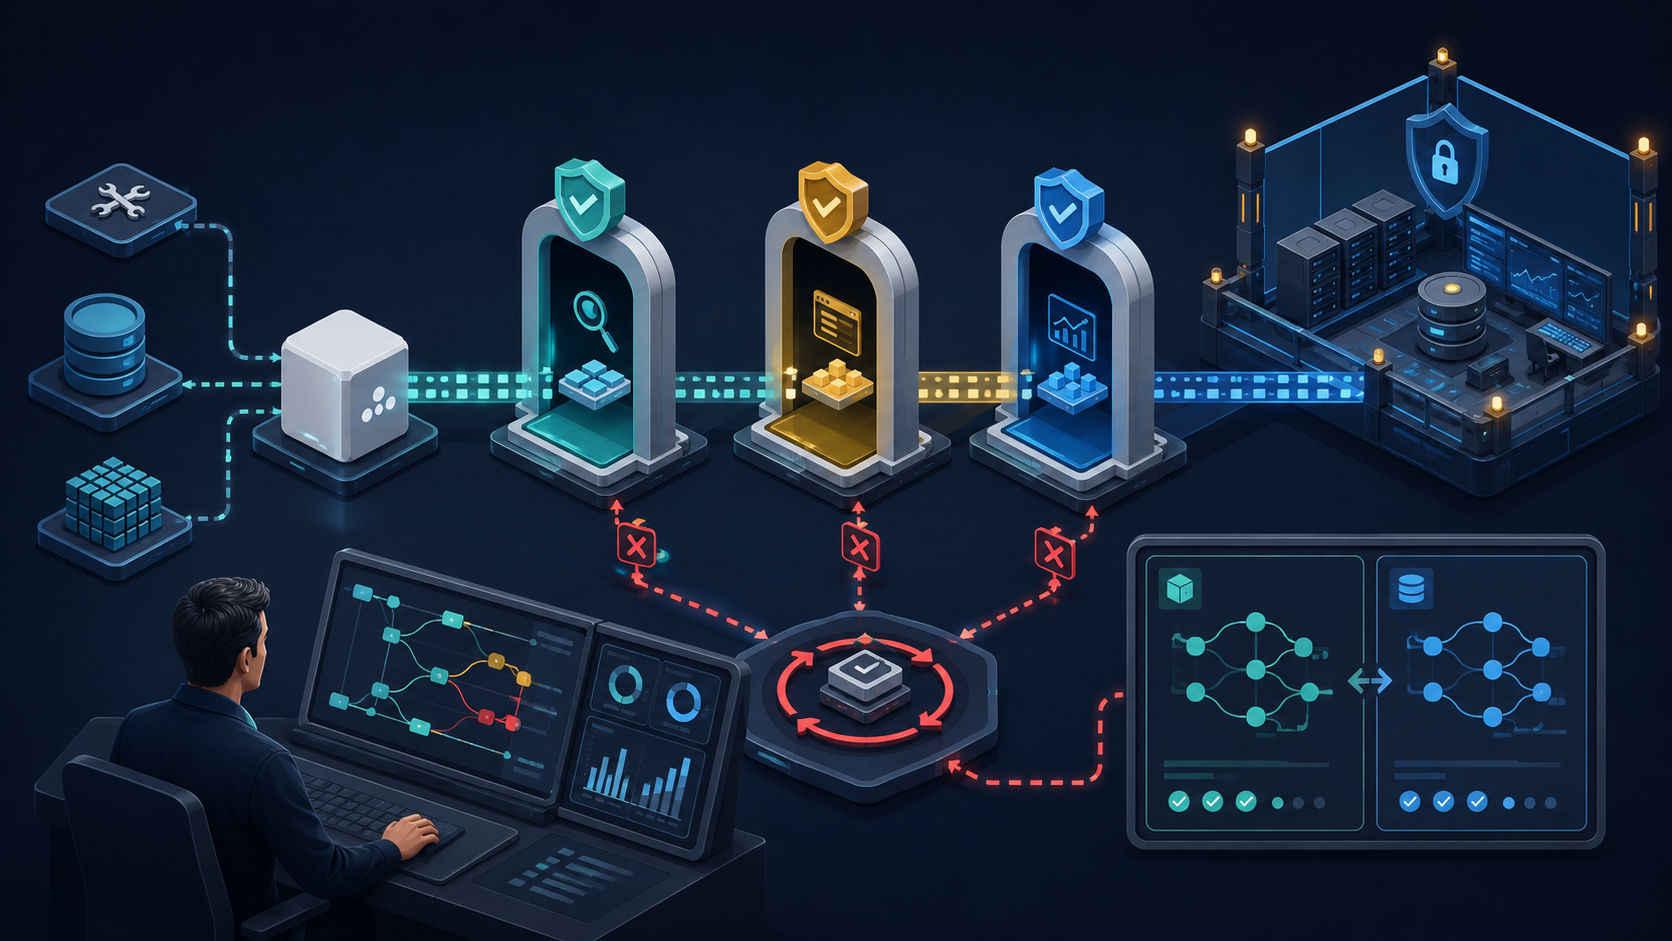
실용적인 품질 관리 체계는 제어 대상을 여러 계층으로 분리해야 한다. 다음 구성은 아키텍처 권고안이며, 하나의 제품이 모든 문제를 자동으로 해결한다는 의미는 아니다.
| 제어 계층 | 확인할 질문 | 보존할 증거 |
|---|---|---|
| 변경 | 후보 버전은 현재 버전과 어떻게 다른가? | 프롬프트, 설정, 모델, 도구, 테스트 세트 |
| 동작 | 에이전트가 의도한 작업을 완료했는가? | 결과, 도구 호출 경로, 인지된 오류, 작업 기준 |
| 런타임 | 실제 트래픽에서만 발생하는 문제는 무엇인가? | 트레이스, 예외, 사용자 피드백, 이상 사례 |
| 상태 | 메모리에 잘못되거나 오래된 정보가 누적되는가? | 데이터 출처, 메모리 변경 내역, 검증 결과 |
메모리는 항상 신뢰할 수 있는 지식 저장소가 아니라 검사 가능한 상태로 다뤄야 한다. OpenWiki의 자기 교정 메모리는 저장된 지식을 검토하고 수정하는 방향을 제시한다. 운영 관점에서 중요한 질문은 에이전트가 얼마나 많이 기억하는지가 아니라 잘못된 기억을 어떻게 탐지하고 추적하며 고치는지다.
이러한 Control Plane 관점은 관리와 정책을 실제 워크로드에서 분리하는 전통적인 인프라 설계와 닮았다. 다양한 도구를 사용하는 에이전트 시스템을 설계한다면 관리형 Control Plane 설계 원칙도 참고할 수 있다. 다만 에이전트에는 별도의 동작 평가와 상태 관리 문제가 존재한다.
개발팀은 어떤 순서로 도입해야 하나?
먼저 도구를 구매한 뒤 측정 대상을 정하는 방식은 피해야 한다. 가치가 있으면서도 범위가 제한된 에이전트 워크플로 하나를 선택하고, 이미 확인된 실패 사례를 반복 실행 가능한 작업으로 전환하는 것이 출발점이다. 각 작업에는 초기 조건, 사용할 수 있는 도구와 성공 기준이 명확해야 한다.
- 기준선 설정: 대표 작업 세트에서 현재 버전의 출력, 트레이스와 실패를 보존한다.
- 변경 격리: 프롬프트, 모델, 도구 또는 메모리 변경을 사용자에게 노출하기 전에 별도로 테스트한다.
- 평가 방식 결합: 가능한 곳에는 결정론적 검사를 사용하고, 코드화하기 어려운 기준에는 evaluator를, 위험도가 높은 사례에는 사람의 검토를 적용한다.
- 피드백 루프 완성: 확인된 프로덕션 장애를 회귀 테스트 세트에 추가하고 메모리의 출처를 보존한다.
- 릴리스 게이트 설정: 품질, 비용과 실패 양상이 합의된 기준을 만족할 때만 배포를 확대한다.
여러 도구나 에이전트를 연결하는 팀은 생성된 텍스트뿐 아니라 권한과 인계 지점도 평가해야 한다. 예를 들어 MCP로 AI 역할을 연결한 제품 워크플로에서는 트레이스, 명확한 책임 경계와 통합 테스트의 중요성이 더 커진다.
앞으로는 발표된 이슈 탐지 개선이 다양한 데이터에서도 재현되는지, 튜닝된 evaluator가 도메인에 따라 얼마나 안정적인지, 프리뷰 빌드가 실제 프로덕션 조건을 충분히 반영하는지 확인해야 한다. 기능 수나 통제된 데모의 완성도보다 이런 질문이 도입 여부를 판단하는 데 더 유용하다.
결론
- AI 에이전트 엔지니어링의 중심은 모델 선택에서 수명 주기 제어로 이동하고 있다.
- 프리뷰 테스트, 평가와 런타임 모니터링은 서로 다른 유형의 실패를 다룬다.
- 하네스, 작업 환경과 메모리는 독립된 구성 요소로 테스트해야 한다.
- 새 도구는 자체 장애 데이터와 회귀 작업을 기준으로 평가하는 것이 안전하다.
관련 글
- Ventura React: 이 경량 컴포넌트 라이브러리는 새 프로젝트에도 적합할까?
- Nova MCP: Cursor와 Claude를 제품 제작 팀으로 바꾸는 방법
- Ansible Automation Orchestrator: 관리형 Control Plane 설계
참고 자료
- How Toyota North America Put Enterprise AI on the Balance Sheet with Deep Agents and LangSmith
- New in LangSmith Engine: >2x better issue detection
- How We Build Agent Environments & Tasks
- Building Self-Correcting Memory in OpenWiki
- Introducing LangSmith Tuned Evaluators, starting with Perceived Error
- LangSmith Preview Builds: Test agent changes before production
- Nvidia just showed that the harness, not the AI model, is now the real hero
개발자가 주목해야 하는 이유
에이전트의 신뢰성은 모델뿐 아니라 이를 둘러싼 실행 시스템에 좌우된다. 개발팀은 동작을 측정하고 변경을 격리하며 상태를 관리하고, 프로덕션 장애를 재현 가능한 테스트로 전환해야 한다.
권장 조치
- 1범위가 제한된 에이전트 워크플로 하나를 선정하고 실제 실패 사례로 회귀 테스트 세트를 만든 뒤, 프리뷰 테스트와 evaluator, 프로덕션 트레이싱을 시험하라.