빠른 요약
- Meta가 Muse Spark에서 증류한 300억 매개변수 오픈 웨이트 모델 Muse Glimmer를 공개했다. 온디바이스 에이전틱 워크플로를 목표로 하지만, 현재 제공된 정보만으로는 지원 하드웨어와 메모리 요구량, 성능 또는 프로덕션 준비 수준을 판단하기 어렵다.
- 로컬 추론이 실용화되면 에이전트의 실행 경계와 데이터 처리 방식을 재설계할 수 있다. 다만 개발팀은 모델 규모보다 라이선스, ExecuTorch 호환성, 실제 장치의 자원 사용량과 도구 호출 안정성을 먼저 검증해야 한다.
- Muse Glimmer의 공식 가중치와 라이선스, ExecuTorch 지원 범위가 공개되는지 추적하고, 도입 전 목표 하드웨어에서 종단 간 에이전트 워크플로를 검증한다.
무슨 일이 있었나
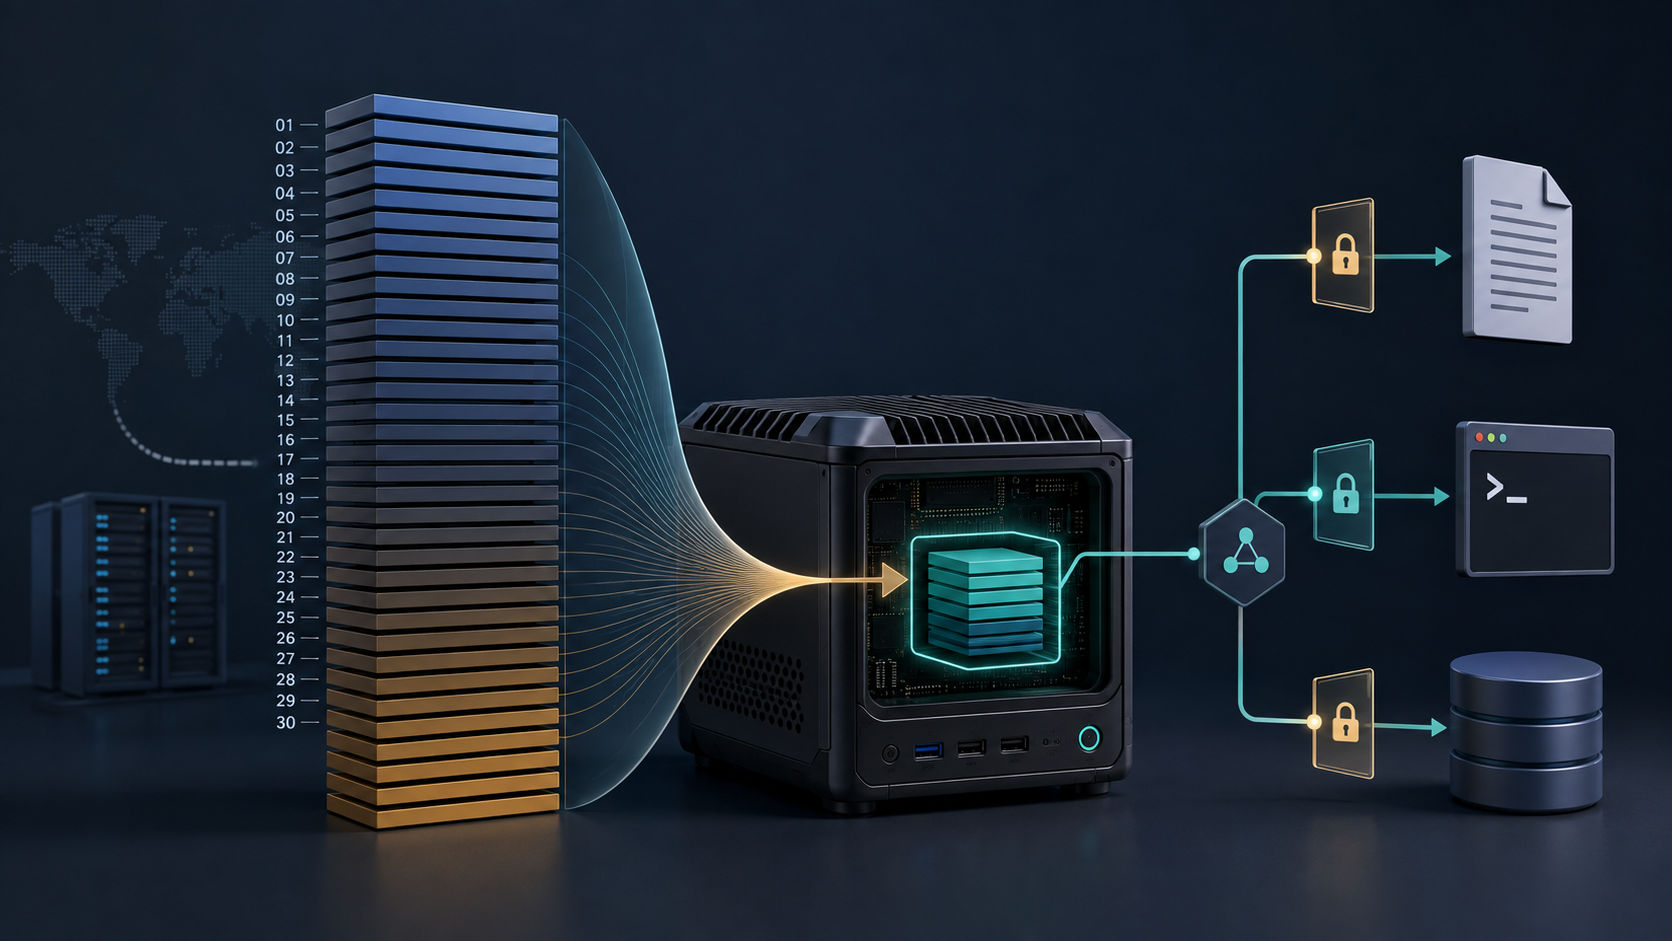
이번 PyTorchKR 커뮤니티 최신 글의 핵심은 Meta가 Muse Glimmer를 공개했다는 소식이다. Muse Glimmer는 Muse Spark에서 증류한 300억 매개변수 오픈 웨이트 모델이며, 온디바이스 에이전틱 워크플로를 목표로 한다.
방향성은 분명하지만 실제 배포 가능성은 아직 별개의 문제다. 온디바이스라는 표현만으로 노트북, 엣지 장치 또는 모든 로컬 GPU에서 적절한 성능으로 실행된다고 판단해서는 안 된다.
현재 확인할 수 있는 발표 내용은 무엇인가?
PyTorch Korea가 소개한 Muse Glimmer 발표에서 확인되는 핵심 사실은 세 가지다. 모델 규모는 300억 매개변수이고, Muse Spark에서 증류했으며, 오픈 웨이트 형태로 소개됐다. 활용 방향은 장치 내부에서 동작하는 에이전틱 워크플로다.
모델 증류는 일반적으로 원본 모델의 출력이나 학습 신호를 이용해 대상 모델에 일부 행동과 능력을 전달하는 방식이다. 그러나 증류됐다는 사실만으로 원본 모델과 품질이 같거나, 특정 작업에서 어느 정도 성능을 유지하는지는 알 수 없다.
오픈 웨이트 역시 완전한 오픈소스와 동일한 표현은 아니다. 가중치 접근 가능성을 나타내지만 상업적 사용, 재배포, 수정, 학습 데이터 공개 또는 학습 코드 제공 범위는 실제 라이선스와 배포 자료를 확인해야 한다.
300억 매개변수만으로 실행 환경을 판단할 수 없는 이유
매개변수 수는 모델 크기를 설명하는 지표지만 메모리 사용량이나 생성 속도를 직접 확정하지 않는다. 가중치 정밀도, 양자화 여부, 컨텍스트 길이, 캐시, 중간 텐서와 실행 백엔드에 따라 필요한 자원이 달라질 수 있다.
제공된 원문 요약은 ExecuTorch와 NVIDIA GPU를 언급하기 시작한 지점에서 잘려 있다. 따라서 이 기록만으로는 어떤 GPU와 운영체제, 가속기 또는 백엔드를 지원하는지 확인할 수 없다. 최저 사양이나 벤치마크 수치도 주어진 자료에는 포함돼 있지 않다.
| 확인된 내용 | 추가 확인이 필요한 내용 |
|---|---|
| 300억 매개변수 규모 | 가중치 형식과 양자화 옵션 |
| Muse Spark에서 증류 | 메모리 요구량과 실제 지연 시간 |
| 오픈 웨이트로 소개 | 구체적인 라이선스 조건 |
| 온디바이스 에이전트 지향 | 지원 장치와 실행 백엔드 |
따라서 모델을 내려받을 수 있다는 사실과 제품의 목표 장치에서 안정적으로 실행할 수 있다는 판단을 분리해야 한다. 메모리뿐 아니라 발열, 전력, 초기 로딩 시간과 지속적인 작업 수행 능력도 실제 배포 조건에 포함된다.
온디바이스 모델은 에이전트 설계를 어떻게 바꾸는가?
에이전트는 모델 하나로 완성되지 않는다. 도구 정의, 인자 검증, 실행 권한, 상태 저장, 반복 종료 조건과 실패 복구를 담당하는 오케스트레이션 계층이 필요하다. 로컬 추론은 이 구조에서 모델의 실행 위치를 바꾸지만 제어 계층의 책임을 없애지는 않는다.
추론을 장치 안에서 수행하면 일부 프롬프트와 컨텍스트를 외부 모델 서버로 보내지 않을 가능성이 생긴다. 다만 이것은 잠재적인 아키텍처 이점이지 개인정보 보호를 자동으로 보장하는 기능은 아니다. 에이전트가 호출하는 API, 플러그인, 검색 서비스와 텔레메트리는 여전히 네트워크를 사용할 수 있다.
같은 이유로 로컬 모델을 사용하는 에이전트도 완전한 오프라인 제품은 아닐 수 있다. 개발팀은 모델 위치만 표시할 것이 아니라 각 도구가 접근하는 데이터, 네트워크 경계와 권한을 별도로 문서화해야 한다.
개발팀은 무엇을 기준으로 검증해야 하는가?
먼저 공식 배포물이 제공되면 라이선스, 체크섬, 가중치 형식, 요구되는 ExecuTorch 버전과 지원 백엔드를 확인해야 한다. 발표 문구나 매개변수 수만으로 통합 작업을 시작하면 하드웨어 또는 배포 조건이 맞지 않을 위험이 있다.
평가 작업은 제품에서 실제로 수행할 작은 시나리오로 구성하는 편이 유용하다. 적절한 도구 선택, 구조화된 인자 생성, 잘못된 결과 처리, 반복 종료와 네트워크 장애 상황을 포함하고 모델 출력뿐 아니라 작업 전체의 성공 여부를 측정해야 한다.
- 프로덕션과 같은 등급의 장치에서 벤치마크한다.
- 최대 메모리, 종단 간 지연 시간, 발열과 실패율을 함께 기록한다.
- 모든 도구 호출에 최소 권한 원칙을 적용한다.
- 최대 실행 단계와 시간, 자원 사용량을 제한한다.
- 로컬 백엔드가 실패할 때 사용할 대체 경로를 설계한다.
비교 대상도 필요하다. 동일한 하드웨어와 작업 집합에서 기존 모델 또는 기존 워크플로를 기준선으로 측정해야 Muse Glimmer 도입의 실질적인 이점을 판단할 수 있다. 공식 자료와 재현 가능한 측정값이 나오기 전까지는 검증이 필요한 후보로 보는 것이 안전하다.
결론
- Muse Glimmer는 Muse Spark에서 증류한 300억 매개변수 오픈 웨이트 모델이다.
- 온디바이스 에이전틱 워크플로를 목표로 하지만 범용 장치 호환성이 확인된 것은 아니다.
- 현재 자료만으로 메모리, 성능, 라이선스와 지원 하드웨어를 확정할 수 없다.
- 공식 배포물을 확인한 뒤 목표 장치에서 에이전트 전체 흐름을 측정해야 한다.
관련 글
참고 자료
개발자가 주목해야 하는 이유
로컬 추론이 실용화되면 에이전트의 실행 경계와 데이터 처리 방식을 재설계할 수 있다. 다만 개발팀은 모델 규모보다 라이선스, ExecuTorch 호환성, 실제 장치의 자원 사용량과 도구 호출 안정성을 먼저 검증해야 한다.
권장 조치
- 1Muse Glimmer의 공식 가중치와 라이선스, ExecuTorch 지원 범위가 공개되는지 추적하고, 도입 전 목표 하드웨어에서 종단 간 에이전트 워크플로를 검증한다.