빠른 요약
- Databricks는 데이터 웨어하우스의 AI_Functions 활용 사례를 제시하고, AWS는 예측과 BI를 위한 노코드 워크플로를 소개합니다. 둘 다 AI를 관리되는 데이터 가까이에 두지만, 웨어하우스 AI 작업과 예측 모델 수명 주기를 혼동해서는 안 됩니다.
- AI를 웨어하우스 가까이에 두면 통합 마찰은 줄일 수 있지만, AI 함수를 호출하는 일은 완전한 ML 시스템을 구축하는 일과 다릅니다.
- 현재 사용 사례를 웨어하우스 작업, 라벨 기반 예측, 분석 문제로 분류한 뒤 측정 가능한 파일럿 하나를 선택하세요.
무슨 일이 있었나
로우코드 ML은 드래그 앤 드롭 인터페이스에만 국한되지 않습니다. Databricks는 데이터 웨어하우스 활용 사례를 통해 AI_Functions를 제시하고, AWS는 Canvas, Data Wrangler, Quick Sight를 예측과 BI를 위한 시각적 워크플로로 설명합니다.
두 접근 모두 관리되는 데이터가 있는 곳 가까이에서 AI를 사용하게 합니다. 하지만 다루는 작업 계층은 다르며, 유용한 아키텍처는 그 차이를 구분하는 데서 시작합니다.
두 가지 출발점, 다른 작업
웨어하우스의 AI 함수는 데이터 및 분석 흐름 안에 AI 작업을 직접 넣는 방식을 시사합니다. 작업이 테이블에서 시작해 웨어하우스 운영 안에 속할 때 유용할 수 있습니다.
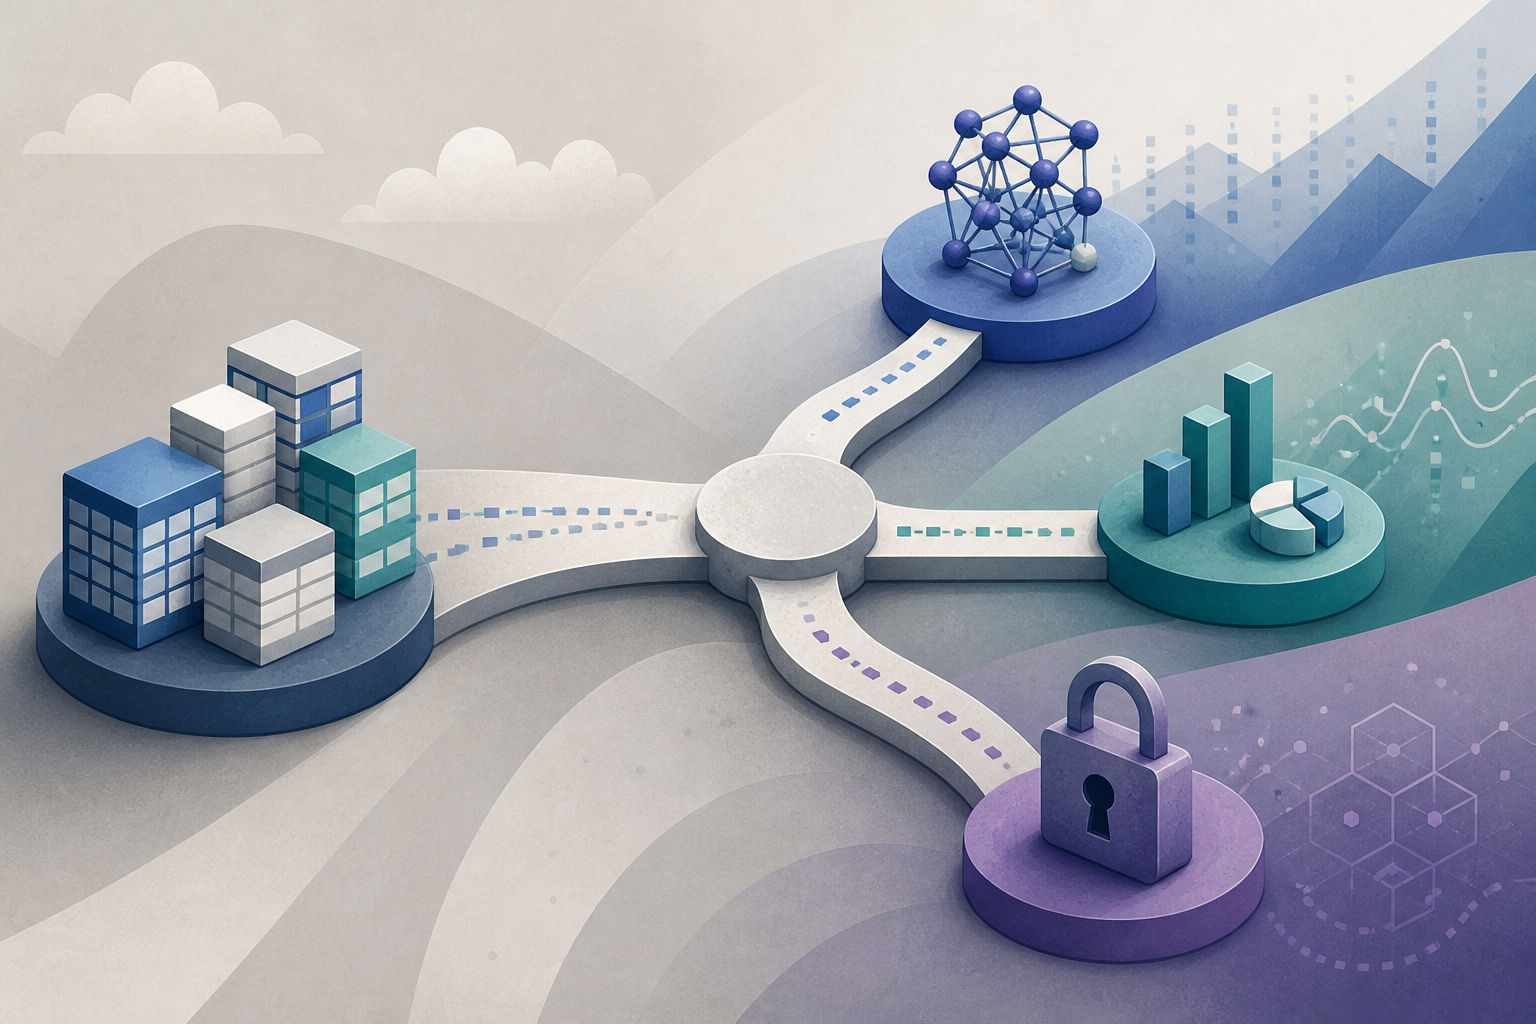
AWS 워크플로는 더 명확한 예측 파이프라인입니다. Snowflake 연결, Data Wrangler에서의 데이터 준비·조인, Canvas에서의 XGBoost 학습, Quick Sight로의 예측 전달 순서입니다. 라벨과 예측 대상이 있는 사용 사례에 맞습니다.
모든 AI 작업을 머신러닝이라 부르지 말 것
AI 함수는 유용한 데이터 작업 인프라가 될 수 있지만, 라벨, 평가, 모니터링, 예측 후 조치 프로세스를 자동으로 제공하지는 않습니다. 마찬가지로 Canvas 모델은 대시보드에 출력이 보인다는 이유만으로 운영 시스템이 되지 않습니다.
먼저 필요를 분류하세요. 웨어하우스 데이터의 변환·보강인지, 정의된 결과의 예측인지, 사용자의 데이터 질의 지원인지에 따라 평가 기준과 책임 구조가 달라집니다.
첫 실험 선택 방법
| 필요 | 적절한 시작점 |
|---|---|
| 웨어하우스 데이터에 가까운 AI 작업 | 데이터 흐름에서 AI Functions 평가 |
| 과거 라벨이 있는 예측 | Canvas와 Snowflake 워크플로 시험 |
| 이해관계자의 결과 탐색 | 대시보드와 자연어 BI 활용 |
이 표는 기능 비교가 아니라 의사결정 틀입니다. 파일럿을 좁게 유지하고 검증 가능한 결과를 고르며 확장 전에 운영 비용을 정의하세요.
최소 아키텍처에도 출구 전략은 필요하다
웨어하우스든 노코드 인터페이스든 입력, 출력, 설정, 책임자를 보존하세요. 테스트, 통합, 지연 시간, 통제 요구사항이 로우코드 계층을 넘어서면 코드나 전용 파이프라인으로 옮길 기준도 정해야 합니다.
5분 요약
- Databricks는 웨어하우스 AI_Functions를, AWS는 시각적 예측·BI 워크플로를 제시합니다.
- SQL 안의 AI와 예측 시스템은 수명 주기가 다릅니다.
- ‘AI’라는 이름이 아니라 작업 유형으로 출발점을 고르세요.
- 산출물을 보관하고 필요할 때 더 많은 코드로 전환할 계획을 세우세요.
참고 자료
- Build a no-code ML workflow with Snowflake, Amazon SageMaker Canvas and Amazon Quick – Part 1: Setting up your Snowflake environment
- Build a no-code ML workflow with Snowflake, Amazon SageMaker Canvas and Amazon Quick – Part 2: Data preparation and model building with Amazon SageMaker Canvas
- Build a no-code ML workflow with Snowflake, Amazon SageMaker Canvas and Amazon Quick – Part 3: Visualizing insights with Amazon Quick Sight
- How Databricks Feature Store serves features with sub-second freshness
- Using AI_Functions in Your Data Warehouse: Top Use Cases
개발자가 주목해야 하는 이유
AI를 웨어하우스 가까이에 두면 통합 마찰은 줄일 수 있지만, AI 함수를 호출하는 일은 완전한 ML 시스템을 구축하는 일과 다릅니다.
권장 조치
- 1현재 사용 사례를 웨어하우스 작업, 라벨 기반 예측, 분석 문제로 분류한 뒤 측정 가능한 파일럿 하나를 선택하세요.