Tóm tắt nhanh
- Databricks đưa complex document extraction vào trọng tâm Document Intelligence. Với doanh nghiệp, đây là cơ hội kết nối tài liệu phi cấu trúc với workflow có kiểm soát thay vì tự động hóa không có ranh giới.
- Tài liệu thường là nơi dữ liệu nghiệp vụ bị kẹt giữa hệ thống và thao tác thủ công; extraction có kiểm soát là bước nền tảng trước khi giao agent quyền hành động.
- Chọn một loại tài liệu lặp lại, thiết kế hàng đợi ngoại lệ và bộ trường cần xác minh trước khi tự động hóa hành động.
Điều gì đã xảy ra
Nhiều quy trình doanh nghiệp bắt đầu bằng tài liệu nhưng kết thúc bằng thao tác thủ công: đọc, đối chiếu, nhập lại và chuyển tiếp. Vì vậy, document intelligence là điểm vào hợp lý cho machine-learning và agentic AI, miễn là extraction được xem như dữ liệu cần kiểm chứng chứ không phải sự thật mặc định.
Databricks Document Intelligence tập trung vào trích xuất từ tài liệu phức tạp. Bản thân tiêu đề này cho thấy vấn đề không chỉ là OCR; workflow phải biến nội dung tài liệu thành đầu ra có cấu trúc đủ tin cậy để một hệ thống khác sử dụng.
Tách extraction khỏi quyết định nghiệp vụ
Một kiến trúc an toàn có ít nhất hai lớp. Lớp đầu tiên trích xuất trường, bảng hoặc thực thể; lớp thứ hai kiểm tra tính đầy đủ, định dạng, mâu thuẫn và ngưỡng tin cậy trước khi dữ liệu đi tiếp.
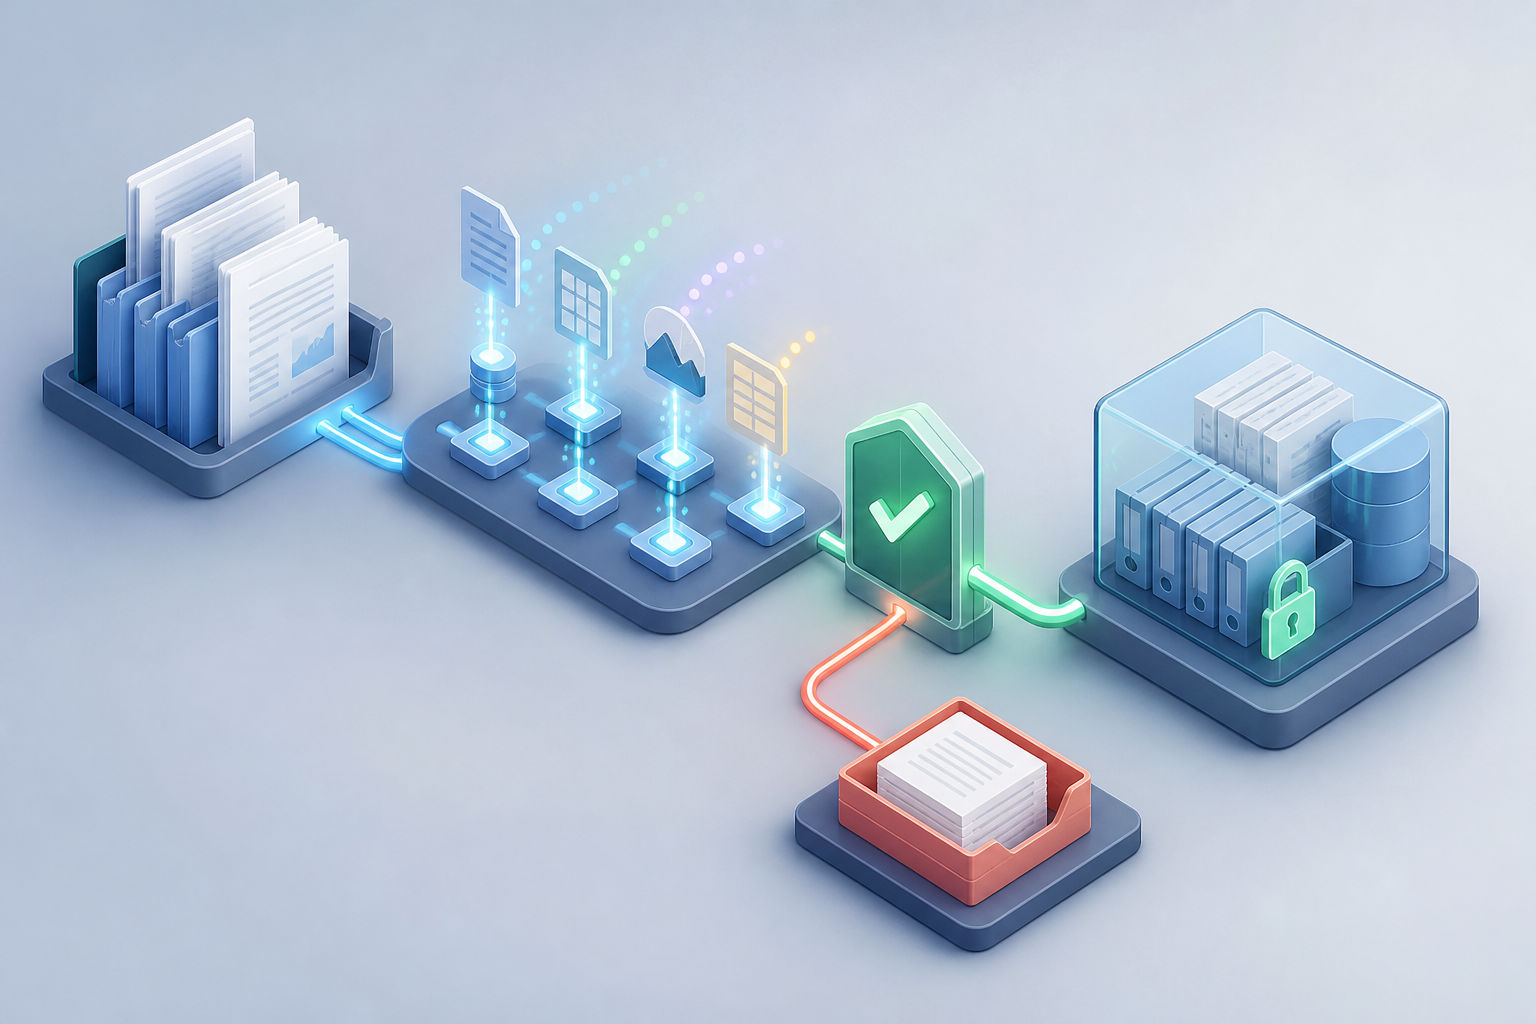
Agent có thể điều phối việc phân loại tài liệu, chọn đường xử lý và gửi ngoại lệ tới người phụ trách. Nhưng không nên để agent tự biến một giá trị được suy luận thành thay đổi không thể đảo ngược trong hệ thống nghiệp vụ khi chưa có chính sách kiểm soát.
Thiết kế đường đi cho ngoại lệ ngay từ đầu
Tài liệu phức tạp tạo ra ngoại lệ: trường thiếu, bố cục khác thường hoặc thông tin mâu thuẫn. Một pilot tốt không che giấu các trường hợp này bằng tỷ lệ thành công chung; nó lưu ảnh gốc, kết quả extraction, lý do định tuyến và quyết định của người xem xét.
Những dữ liệu đó giúp đội ngũ xác định loại tài liệu nào phù hợp để tự động hóa trước, và loại nào cần tiếp tục review. Đây cũng là nền tảng để cải thiện prompt, rule và tiêu chí đánh giá mà không đánh đổi khả năng audit.
Đo chất lượng theo tác động downstream
Đừng chỉ hỏi extraction có vẻ đúng hay không. Hãy đo tỷ lệ trường được xác minh, tỷ lệ ngoại lệ, thời gian xử lý và số lỗi lọt vào hệ thống downstream. Các chỉ số này liên kết năng lực mô hình với rủi ro vận hành thật.
Trong 5 phút
- Document intelligence biến tài liệu phức tạp thành đầu vào có cấu trúc cho workflow.
- Tách extraction, kiểm chứng và quyết định hành động.
- Đường xử lý ngoại lệ cần lưu bằng chứng và quyết định review.
- Đo chất lượng theo lỗi downstream, không chỉ theo ấn tượng.
Nguồn tham khảo
- Agentic Data Operations Platform (ADOP): Data engineering into hours
- Connecting retail demand planning to campaign and store execution
- Designing effective Genie Agents from a single prompt
- Databricks Document Intelligence: pushing the frontier for complex document extraction
- When it comes to Governance, Retailers need a control plane for context
Vì sao developer cần quan tâm
Tài liệu thường là nơi dữ liệu nghiệp vụ bị kẹt giữa hệ thống và thao tác thủ công; extraction có kiểm soát là bước nền tảng trước khi giao agent quyền hành động.
Hành động đề xuất
- 1Chọn một loại tài liệu lặp lại, thiết kế hàng đợi ngoại lệ và bộ trường cần xác minh trước khi tự động hóa hành động.