Tóm tắt nhanh
- Một model có năng lực và chi phí hợp lý, bao gồm DeepSeek trong các workload phù hợp, chưa tự động là một hệ thống production-grade. Độ tin cậy đến từ harness: định tuyến công cụ, quản lý ngữ cảnh và bộ nhớ, khôi phục trạng thái, đánh giá, quan sát, quyền hạn, rào chắn an toàn và hạ tầng serving.
- Lựa chọn model ảnh hưởng đến chi phí và chất lượng, nhưng harness quyết định hệ thống có thể vận hành an toàn, đo lường được và phục hồi khi xảy ra lỗi hay không. Đội ngũ cần đánh giá toàn bộ vòng đời của một tác vụ, thay vì chỉ so sánh giá token hoặc điểm benchmark.
- Trong hai tuần, triển khai một gateway tối thiểu cho một workflow: log trace theo request, giới hạn token và tool call, capability theo quyền tối thiểu, checkpoint trước hành động ghi, cùng bộ đánh giá gồm lỗi công cụ và prompt injection. Chỉ sau đó mới so sánh DeepSeek với lựa chọn khác theo chi phí trên kết quả thành công.
Điều gì đã xảy ra
Một model mở có năng lực tốt và chi phí hợp lý có thể là một thành phần hấp dẫn trong sản phẩm AI. Tuy nhiên, model không tự nó tạo nên một hệ thống production-grade. Khi model phải tìm kiếm thông tin, gọi công cụ, truy cập dữ liệu khách hàng, tiếp tục một quy trình bị gián đoạn hoặc đưa ra kết quả có hậu quả kinh doanh, chất lượng thực tế phụ thuộc vào harness: lớp hệ thống bao quanh model.
Luận điểm biên tập: với DeepSeek cũng như các model khác, năng lực và kinh tế của model chỉ trở thành giá trị vận hành khi harness cung cấp định tuyến, ngữ cảnh, bộ nhớ, khôi phục trạng thái, đánh giá, quan sát, quyền hạn, rào chắn an toàn và inference serving. Đây là một kết luận kiến trúc, không phải tuyên bố rằng DeepSeek đã xây dựng, sử dụng hoặc chứng thực một harness cụ thể.
Điều nguồn đã xác nhận và điều bài viết suy luận
Thông tin đã được nguồn xác nhận: báo cáo của Vercel nói rằng trong tháng 8, DeepSeek vượt Google về volume trên nền tảng của Vercel, trong khi chi phí mỗi token giảm 13,6%; bài viết liên hệ diễn biến này với tỷ trọng open-weight model cao hơn và các use case phức tạp hơn. Một hướng dẫn về vLLM mô tả các vấn đề phục vụ và mở rộng inference cho agent. Meta cũng công bố các ví dụ về kiến trúc xếp hạng nhiều giai đoạn và cho biết công việc GEM training của họ đã tăng gấp đôi hiệu quả huấn luyện cho một foundation model quảng cáo ở quy mô LLM.
Suy luận biên tập: những tín hiệu đó không chứng minh một model, nhà cung cấp hay kiến trúc sẽ phù hợp với mọi workload. Chúng hỗ trợ một kết luận thực dụng hơn: khi lưu lượng và mức độ tự động hóa tăng, chi phí, độ trễ, độ tin cậy và rủi ro không còn nằm trong một lệnh gọi API. Chúng phải được quản trị bằng một harness dùng chung.
Harness là gì trong một hệ thống AI?
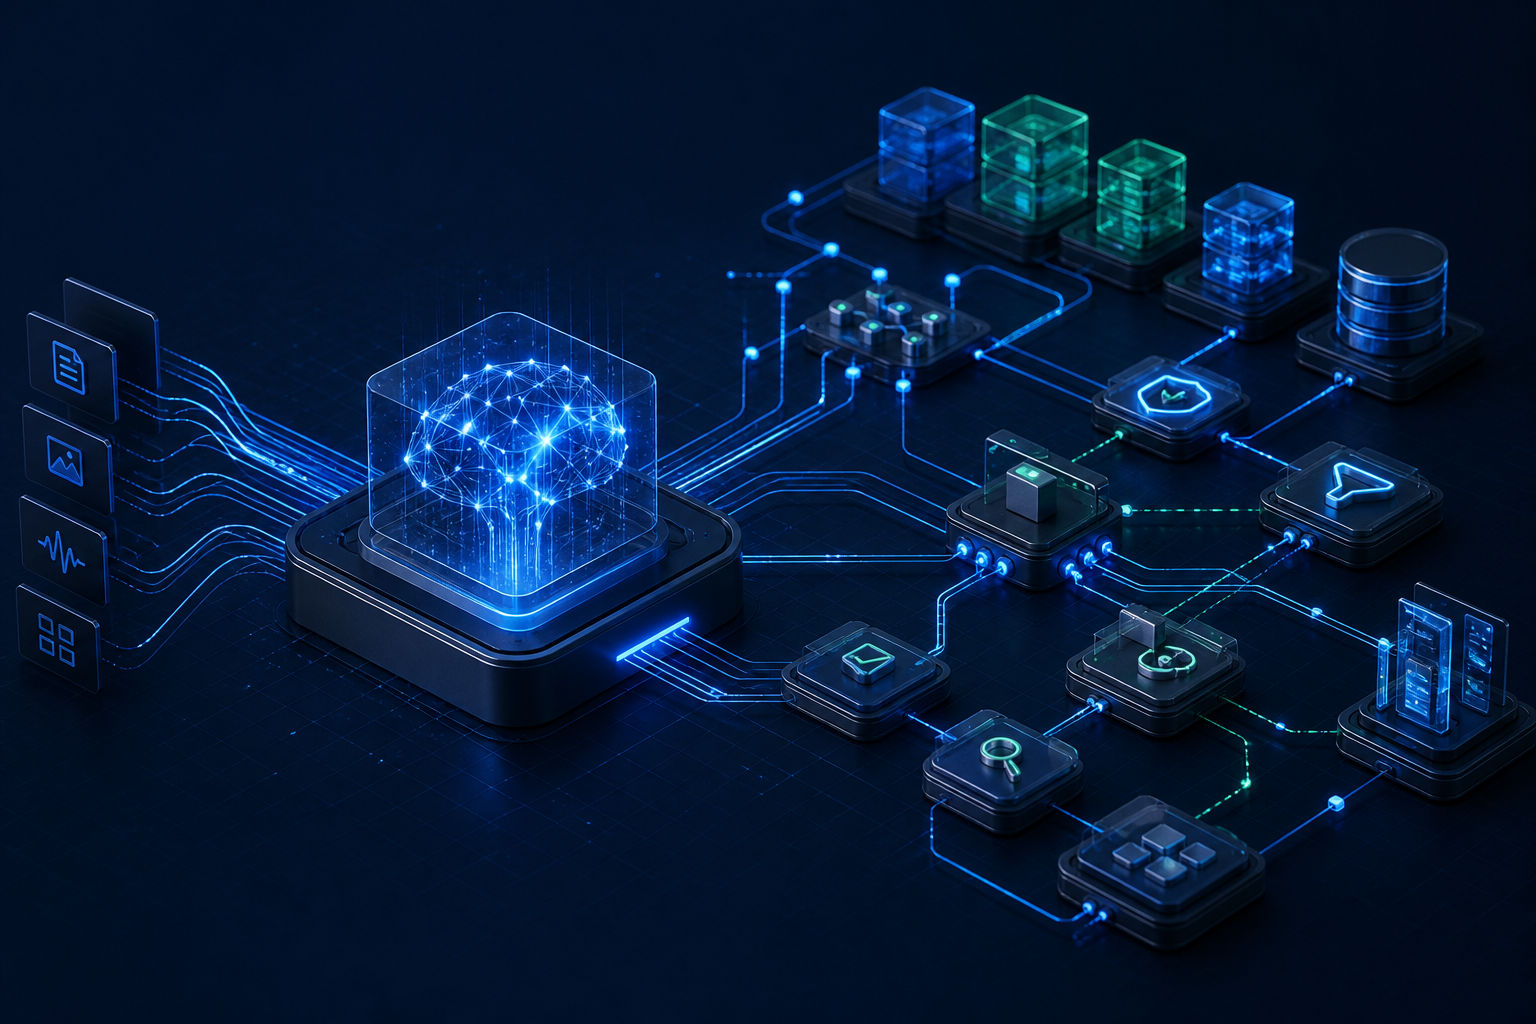
Harness là tập hợp các cơ chế phần mềm và vận hành biến đầu ra xác suất của model thành một quy trình có giới hạn, có trạng thái và có thể kiểm tra. Nó không đồng nghĩa với prompt dài hơn, một framework agent duy nhất hoặc tự host model. Một harness có thể nằm trước, sau và xung quanh bất kỳ API model hoặc endpoint self-hosted nào.
Khái niệm này phù hợp với lập luận của Pulumi về việc xây harness thay vì chỉ tinh chỉnh prompt: trong môi trường kỹ thuật thực, các tệp hướng dẫn, hook, kỹ năng, công cụ và vòng phản hồi thường ảnh hưởng lớn đến kết quả. Bài viết này mở rộng nguyên tắc đó sang vận hành production: harness phải kiểm soát không chỉ cách model suy luận mà cả cách hệ thống cấp quyền, đo lường, retry và thất bại an toàn.
Tám năng lực biến model thành hệ thống production-grade
1. Định tuyến model và công cụ
Không phải yêu cầu nào cũng cần cùng một model hoặc cùng mức quyền truy cập. Harness nên phân loại tác vụ trước: truy vấn đơn giản, trích xuất có cấu trúc, tóm tắt tài liệu, suy luận nhiều bước và hành động qua công cụ. Sau đó, nó chọn model, prompt template, giới hạn token, toolset và chế độ đồng bộ hoặc bất đồng bộ phù hợp.
Đây là suy luận kiến trúc từ dữ liệu kinh tế model, không phải một hướng dẫn riêng của DeepSeek. Báo cáo Vercel cho thấy model mix và volume có thể thay đổi nhanh; vì vậy, một lớp routing giúp đội ngũ thử nghiệm có kiểm soát thay vì gắn chặt sản phẩm vào một đường gọi duy nhất.
2. Ngữ cảnh và bộ nhớ có kỷ luật
Ngữ cảnh hữu ích không phải là đưa toàn bộ lịch sử vào prompt. Harness cần xác định nguồn dữ liệu nào được phép dùng, dữ liệu nào còn mới, phần nào phải được trích dẫn, và dữ liệu cá nhân nào phải bị loại bỏ hoặc che giấu. Bộ nhớ dài hạn nên có chính sách lưu giữ, phạm vi tenant, thời hạn hết hiệu lực và cơ chế xóa.
Trong thực tế, hãy tách ít nhất ba lớp: trạng thái phiên ngắn hạn; dữ kiện đã được xác minh phục vụ tác vụ; và bộ nhớ người dùng được cấp phép rõ ràng. Mỗi mục nên có nguồn gốc, thời điểm tạo và quyền truy cập. Nếu không có các thuộc tính này, hệ thống khó giải thích vì sao model biết một điều hoặc ngăn rò rỉ dữ liệu giữa người dùng.
3. Trạng thái, checkpoint và khôi phục
Agent có nhiều bước sẽ gặp timeout, lỗi công cụ, thay đổi dữ liệu hoặc yêu cầu phê duyệt của con người. Harness cần lưu trạng thái workflow theo một định danh bền vững: mục tiêu, đầu vào đã chuẩn hóa, các công cụ đã gọi, kết quả trung gian, phiên bản prompt/model và quyết định đã được phê duyệt.
Thiết kế thao tác công cụ theo hướng idempotent khi có thể. Khi retry, hệ thống phải biết hành động nào đã hoàn thành để không gửi trùng email, tạo trùng phiếu hỗ trợ hoặc thực hiện trùng giao dịch. Với thao tác có tác động bên ngoài, checkpoint trước khi thực thi và yêu cầu xác nhận sau khi model đề xuất hành động là các biện pháp cơ bản.
4. Đánh giá trước và sau triển khai
Benchmark chung không thay thế cho đánh giá trên tác vụ thực. Hãy tạo bộ ca kiểm thử đại diện gồm đầu vào bình thường, dữ liệu thiếu, yêu cầu mơ hồ, prompt injection, lỗi công cụ và trường hợp có hậu quả cao. Chấm cả chất lượng đầu ra lẫn hành vi quy trình: model có chọn đúng công cụ, tôn trọng quyền, trích đúng nguồn và dừng đúng lúc không?
Đánh giá nên chạy khi thay model, prompt, tool schema, retrieval index hoặc cấu hình serving. Chỉ số cần gắn với kết quả thành công của workflow, không chỉ với mức tiêu thụ token. Đây là nơi một model kinh tế hơn có thể không rẻ hơn trên thực tế nếu tỷ lệ retry, leo thang sang model mạnh hơn hoặc tỷ lệ sửa thủ công tăng.
5. Quan sát và kiểm toán
Mỗi lần chạy cần trace xuyên suốt: phiên bản model, nhà cung cấp hoặc endpoint, token đầu vào/đầu ra, độ trễ hàng đợi và inference, tool call, retry, cache hit, lỗi, chi phí ước tính và kết quả cuối. Log phải tránh lưu bí mật và dữ liệu cá nhân không cần thiết, nhưng vẫn đủ để tái hiện sự cố trong phạm vi được cấp quyền.
Theo dõi p50 và p95 latency, tỷ lệ lỗi tool, tỷ lệ hoàn tất workflow, chi phí trên kết quả thành công, tỷ lệ can thiệp của con người và tỷ lệ từ chối an toàn. Một dashboard tổng chi phí AI không thể chỉ ra pipeline nào đang tạo ra retry hoặc lỗi quyền hạn.
6. Quyền hạn tối thiểu và phê duyệt
Model không nên nhận trực tiếp thông tin xác thực có quyền rộng. Harness phải cấp capability ngắn hạn, giới hạn theo tenant, tác vụ, tập dữ liệu và thời gian. Tool gateway nên kiểm tra schema đầu vào, cho phép theo danh sách, giới hạn tốc độ và ghi audit log trước khi gọi hệ thống bên ngoài.
Phân biệt rõ thao tác đọc, thao tác ghi có thể đảo ngược và thao tác không thể đảo ngược. Các hành động như chuyển tiền, xóa dữ liệu, thay đổi quyền truy cập hoặc gửi thông điệp hàng loạt cần chính sách phê duyệt độc lập với kết luận của model.
7. Rào chắn an toàn và đường thoát
Rào chắn không nên chỉ là một câu lệnh trong system prompt. Chúng cần xuất hiện ở nhiều tầng: lọc đầu vào; truy xuất dữ liệu theo quyền; kiểm tra tham số tool; phát hiện nội dung hoặc hành động bị cấm; giới hạn chi phí và thời gian; cùng một đường escalations đến con người hoặc trải nghiệm giảm cấp.
Không có rào chắn nào loại bỏ hoàn toàn rủi ro. Prompt injection, dữ liệu retrieval không đáng tin và hành vi không ổn định của model vẫn là giới hạn cần được giả định trong thiết kế. Vì thế, hệ thống tốt phải có khả năng từ chối, trì hoãn hoặc yêu cầu xác minh thay vì buộc model phải hoàn thành mọi yêu cầu.
8. Inference serving và độ tin cậy vận hành
Serving quyết định khả năng áp dụng chính sách trên dưới tải: giới hạn concurrency, queue, batching, cache, timeout, rate limit, fallback, rollout phiên bản và cô lập tenant. vLLM là một lựa chọn thường được thảo luận cho serving LLM; nguồn được cung cấp mô tả nó trong ngữ cảnh scale inference cho agent. Điều đó không có nghĩa self-hosting luôn tốt hơn API được quản lý.
Hãy so sánh tổng chi phí sở hữu: GPU, năng lực nhàn rỗi, điện năng, làm mát, bảo mật, nhân sự trực vận hành và mục tiêu phục hồi, chứ không chỉ giá mỗi token. Các ràng buộc vật lý này được trình bày thêm trong bài về GPU, điện năng, làm mát và trung tâm dữ liệu.
Một lộ trình triển khai thực tế
- Chọn một workflow hẹp: ưu tiên tác vụ có giá trị rõ, dữ liệu đầu vào xác định và khả năng đo kết quả.
- Đặt hợp đồng workflow: xác định đầu vào, đầu ra có cấu trúc, tool được phép, giới hạn token/thời gian, điều kiện dừng và người chịu trách nhiệm phê duyệt.
- Xây gateway dùng chung: đưa xác thực, routing, quota, logging, redaction và chính sách retry vào một điểm kiểm soát thay vì nhúng vào từng ứng dụng.
- Version hóa mọi thành phần: model, prompt, tool schema, retrieval corpus và policy phải xuất hiện trong trace và bộ đánh giá.
- Triển khai theo giai đoạn: chạy shadow hoặc canary, so sánh với quy trình hiện tại, sau đó mở rộng theo ngưỡng chất lượng, chi phí và an toàn đã định trước.
- Diễn tập lỗi: kiểm thử provider chậm, tool trả lỗi, quota cạn, retrieval bị nhiễm dữ liệu và workflow bị gián đoạn.
Nguyên tắc platform engineering vẫn áp dụng: tạo một “paved path” với logging, quota, secret management và observability, như bài viết về developer experience và platform engineering đề cập. Điều này giúp các nhóm đổi model hoặc serving backend mà không phải sao chép lại cơ chế kiểm soát.
Giới hạn của luận điểm
Harness tốt không biến một model không phù hợp thành model phù hợp. Nếu model không đủ chất lượng cho miền chuyên môn, không tuân thủ định dạng quan trọng hoặc không đáp ứng yêu cầu pháp lý, routing và guardrail chỉ có thể hạn chế thiệt hại chứ không tạo ra năng lực nền tảng.
Ngược lại, harness cũng có chi phí: độ trễ bổ sung, công sức vận hành, độ phức tạp tích hợp và nguy cơ tạo thêm điểm lỗi. Đội ngũ nhỏ không cần xây một nền tảng lớn trước khi có workload rõ ràng. Họ nên bắt đầu bằng gateway tối thiểu, trace, giới hạn quyền và bộ đánh giá; chỉ bổ sung bộ nhớ dài hạn, đa model hay self-hosting khi số liệu cho thấy cần thiết.
Kết luận: đánh giá DeepSeek như một thành phần, vận hành harness như một sản phẩm
Dữ liệu được cung cấp cho thấy DeepSeek là một phần đáng chú ý của bức tranh thay đổi về usage và chi phí token, nhưng không xác lập một lựa chọn phổ quát. Câu hỏi production-grade không phải chỉ là “model nào rẻ hơn?” mà là “hệ thống có thể kiểm soát, đo lường, phục hồi và giải trình một workflow có model hay không?”
Đối với DeepSeek hoặc bất kỳ model nào, câu trả lời nằm ở harness. Model tạo ra khả năng; harness quyết định khả năng đó có thể được giao cho người dùng với giới hạn chi phí, độ tin cậy và an toàn chấp nhận được hay không.
Nguồn tham khảo
- Vercel: DeepSeek overtakes Google on volume, cost per token falls 13.6%
- freeCodeCamp: How to Scale LLM Inference for AI Agents Using vLLM
- Pulumi: Stop Tuning Prompts. Build a Harness.
- Lilian Weng: Harness Engineering for Self-Improvement
- Meta Engineering: From User Sequences to Scaling Laws
- Meta Engineering: GEM Training
- ByteVora: Hạ tầng AI, GPU, điện năng, làm mát và trung tâm dữ liệu
Vì sao developer cần quan tâm
Lựa chọn model ảnh hưởng đến chi phí và chất lượng, nhưng harness quyết định hệ thống có thể vận hành an toàn, đo lường được và phục hồi khi xảy ra lỗi hay không. Đội ngũ cần đánh giá toàn bộ vòng đời của một tác vụ, thay vì chỉ so sánh giá token hoặc điểm benchmark.
Hành động đề xuất
- 1Trong hai tuần, triển khai một gateway tối thiểu cho một workflow: log trace theo request, giới hạn token và tool call, capability theo quyền tối thiểu, checkpoint trước hành động ghi, cùng bộ đánh giá gồm lỗi công cụ và prompt injection. Chỉ sau đó mới so sánh DeepSeek với lựa chọn khác theo chi phí trên kết quả thành công.