빠른 요약
- 프로덕션 AI는 DevOps의 관리 범위를 컨테이너 배포에서 GPU 용량, 추론 우선순위, 재현 가능한 실험 환경, 모델 수명주기로 넓히고 있다. OpenShift AI 중심 자료를 종합하면 각 요소를 독립적으로 측정하면서 하나의 운영 체계로 연결하는 접근이 필요하다.
- GPU가 할당됐다는 사실만으로 효율적인 사용이나 안정적인 응답을 보장할 수 없다. 비용과 서비스 품질을 함께 관리하려면 자원 회수, 요청 우선순위, 모델 아티팩트, 관측 가능성을 연계해야 한다.
- GPU 기반 추론 서비스 하나를 골라 사용률, 큐, 지연 시간, 장애, 출력 품질의 기준선을 만든 뒤 최적화 기법을 하나씩 독립적으로 시험한다.
무슨 일이 있었나
AI 모델을 프로덕션에 올리는 작업은 컨테이너 하나를 추가하는 것으로 끝나지 않는다. GPU라는 제한된 자원 위에서 대화형 노트북, 파인튜닝, 배치 작업, RAG 파이프라인, 실시간 추론이 서로 다른 요구 조건으로 경쟁한다.
OpenShift AI를 중심으로 제시된 여러 가이드는 이 문제를 세 영역으로 나눠 보여준다. GPU 용량을 관리하고, 추론 트래픽을 제어하며, 실험부터 배포까지 모델 수명주기를 재현 가능하게 만드는 것이 프로덕션 AI DevOps의 핵심이다.
프로덕션 AI는 기존 DevOps와 무엇이 다른가?
일반적인 애플리케이션은 CPU, 메모리, 요청량, 레플리카를 중심으로 확장 전략을 세운다. AI 워크로드에는 GPU 스케줄링과 모델 메모리, 긴 실행 시간을 가진 학습 작업, 지연 시간에 민감한 추론 요청이 추가된다.
여기서 GPU 할당과 실제 활용은 다른 지표다. GPU-pruner로 Kubernetes의 GPU 할당 낭비를 줄이는 가이드는 사용하지 않는 할당을 운영 차원에서 관리해야 한다는 문제를 다룬다. 하드웨어 증설을 검토하기 전에 이미 확보한 용량이 유효한 작업에 쓰이는지 확인할 필요가 있다.
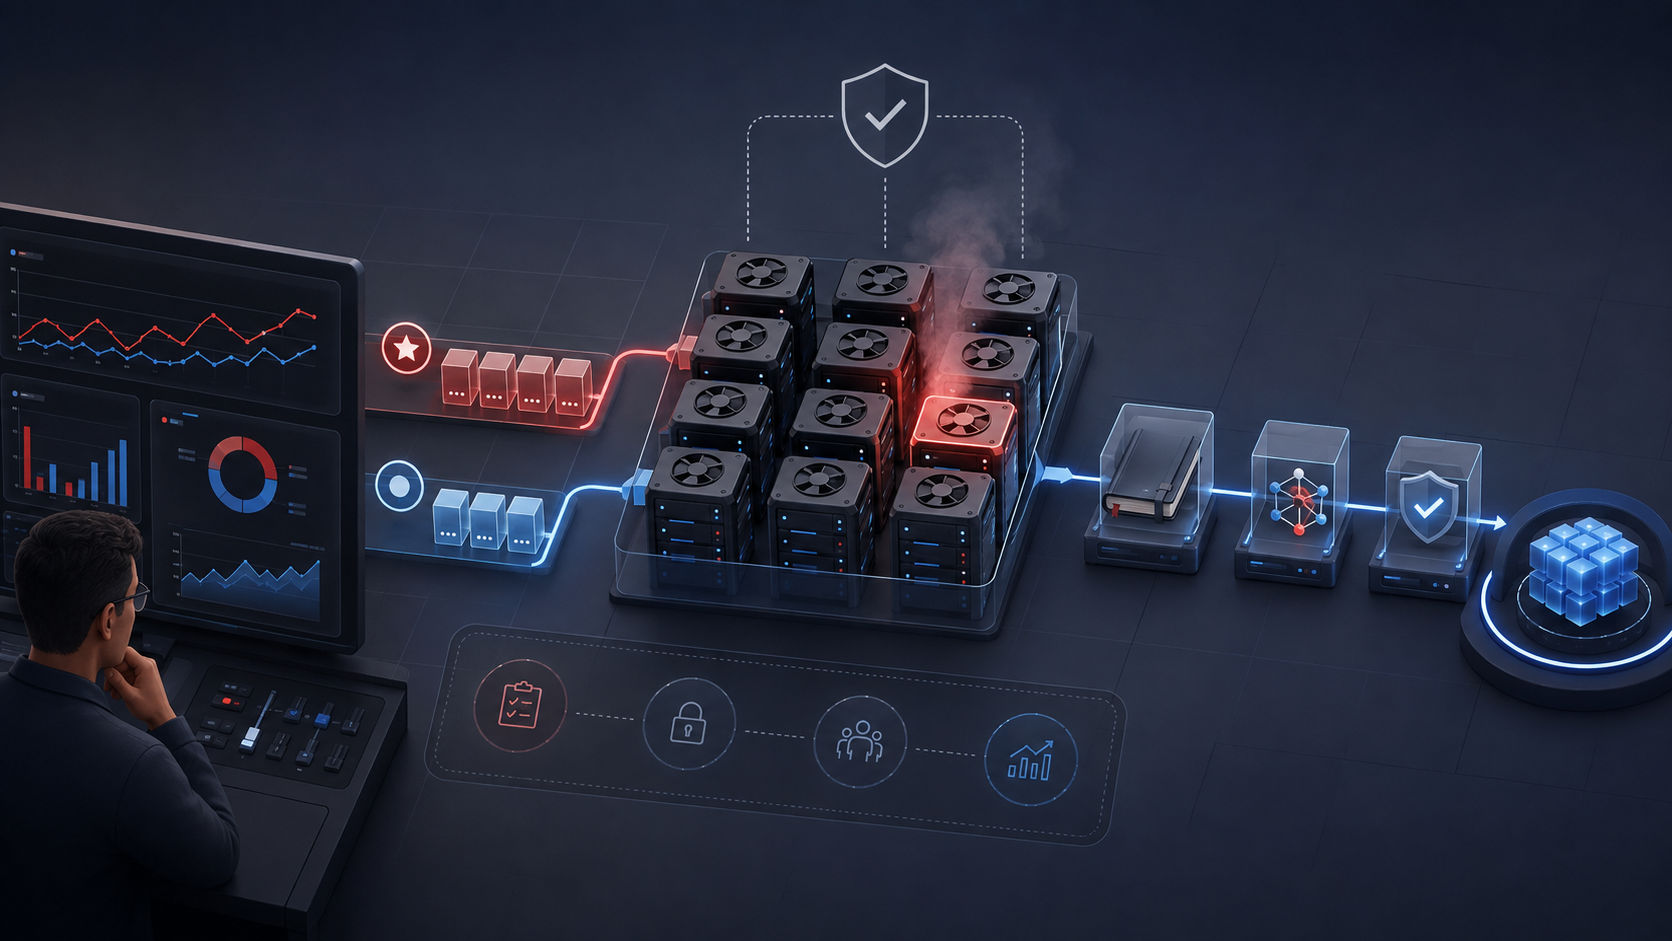
사용 가능한 GPU를 어떤 요청이 먼저 사용할지도 별도 문제다. 사용자 요청과 내부 평가 작업이 동일한 추론 자원을 공유한다면 단순한 도착 순서만으로 서비스 중요도를 표현하기 어렵다. llm-d의 공유 GPU 추론용 우선순위 큐는 서빙 계층에 트래픽 정책을 넣는 접근을 제시한다.
따라서 용량 관리와 흐름 제어를 분리해야 한다. 전자는 워크로드가 GPU를 계속 점유해야 하는지 판단하고, 후자는 현재 사용 가능한 추론 용량을 어떤 요청에 배정할지 결정한다.
GPU와 모델 서빙은 어떤 기준으로 최적화해야 하나?
운영 모델은 GPU 할당, 요청 수용 정책, 모델 효율을 각각 관찰할 수 있어야 한다. 모든 문제를 레플리카 증설로 처리하면 지연 시간의 원인이 자원 경합인지, 잘못된 우선순위인지, 모델 크기인지 구분하기 어렵다.
| 운영 질문 | 적용할 제어 | 확인할 신호 |
|---|---|---|
| 할당된 GPU가 실제 작업에 쓰이는가? | 할당 검토와 유휴 자원 회수 | GPU 사용률과 유휴 시간 |
| 중요 요청이 낮은 우선순위 작업에 막히는가? | 우선순위 클래스와 큐 | 클래스별 지연 시간과 큐 깊이 |
| 모델이 현재 서빙 한도에 적합한가? | 양자화 가능성 평가 | 메모리, 처리량, 출력 품질 |
양자화는 가중치나 연산에 사용하는 수치 표현의 정밀도를 낮추는 기법이다. 배포 조건을 개선할 수 있지만 모델과 태스크에 따라 품질 영향이 달라질 수 있다. LLM 양자화 가이드를 출발점으로 삼되, 실제 도입 여부는 서비스 데이터와 평가 세트로 검증해야 한다.
RAG 서비스라면 모델 엔드포인트만 관찰해서는 충분하지 않다. 검색, 컨텍스트 구성, 생성 과정이 하나의 요청 경로를 이루기 때문이다. OpenShift AI에서 프로덕션 RAG를 오케스트레이션하는 접근처럼 파이프라인 전체를 운영 단위로 보는 것이 적절하다.
개발팀은 단계별 지연과 실패를 추적해야 한다. 검색 결과가 부정확한 상황에서는 GPU를 추가하거나 생성 속도를 높여도 최종 응답의 유용성이 개선되지 않는다.
실험에서 배포까지 어떻게 재현성을 확보할까?
수명주기 문제는 모델 배포 전부터 시작된다. 실행 시점마다 패키지를 내려받거나 설정 과정이 문서화되지 않은 노트북은 동일한 결과를 다시 만들기 어렵다. Open Data Hub와 OpenShift AI용 hermetic notebook image는 개발 환경 자체를 버전이 지정된 아티팩트로 취급하는 방향을 보여준다.
파인튜닝 방식도 목적에 따라 구분해야 한다. 관련 자료는 Ray를 활용한 OpenShift AI의 LoRA 파인튜닝과 검증 가능한 보상을 이용한 GRPO를 각각 다룬다. 두 방법은 교체 가능한 배포 옵션이 아니며, 목표 행동과 데이터, 평가 방식, 컴퓨팅 예산에 맞춰 선택해야 한다.
실험 결과에는 모델 가중치뿐 아니라 비교와 추적에 필요한 메타데이터도 남아야 한다. MLflow를 이용한 AI 옵저버빌리티는 실험 및 모델 추적을 운영과 연결한다. 학습 실행, 모델 버전, 서빙 설정, 프로덕션 지표에 일관된 식별자를 사용해야 이 연결을 실제 장애 분석에 활용할 수 있다.
이 구조는 단순한 대시보드보다 관리형 control plane에 가깝다. 거버넌스를 포함한 자동화 Control Plane 설계에서처럼 원하는 상태, 실행 권한, 변경 이력, 감사 가능성을 분리하면 모델 승격과 인프라 변경도 더 안전하게 관리할 수 있다.
현실적인 도입 순서는 무엇인가?
여러 최적화 기법을 한꺼번에 적용하면 문제가 생겼을 때 원인을 찾기 어렵다. 먼저 측정 가능한 트래픽과 품질 평가 기준을 가진 GPU 추론 서비스 하나를 선택하는 편이 안전하다.
- 기준선 측정: GPU 할당과 사용률, 큐 깊이, 백분위 지연 시간, 오류, 처리량, 출력 품질을 함께 기록한다.
- 워크로드 분류: 노트북, 파인튜닝, 배치 추론, 온라인 추론을 나누고 대기하거나 유휴 할당을 반환할 수 있는 작업을 정한다.
- 서빙 정책 정의: 우선순위 클래스와 과부하 시 동작을 먼저 문서화한 뒤 큐를 구현한다.
- 아티팩트 연결: 노트북 이미지, 학습 설정, 모델, 서빙 파라미터, 배포 매니페스트를 함께 버전 관리한다.
- 점진적 자동화: Helm이나 GitOps를 사용할 경우 검토, 정책 검사, 평가 게이트, 롤백 절차를 배포 흐름에 포함한다.
이 순서는 모든 OpenShift 클러스터에 동일한 구성이 적합하다는 주장이 아니라 운영 권고다. GPU 회수, 우선순위 큐, 양자화를 먼저 개별적으로 시험하고 인프라 지표와 모델 품질을 함께 비교해야 한다.
결론
- 프로덕션 AI DevOps는 GPU 용량, 트래픽 제어, 모델 수명주기를 구분해 관리해야 한다.
- GPU 회수와 우선순위 큐는 각각 자원 효율과 서비스 품질을 해결한다.
- 재현 가능한 노트북 이미지와 연결된 메타데이터가 신뢰할 수 있는 관측의 기반이다.
- 기준선을 유지하며 한 번에 하나씩 변경하고 항상 롤백 경로를 확보해야 한다.
관련 글
- Ventura React: 이 경량 컴포넌트 라이브러리는 새 프로젝트에도 적합할까?
- Nova MCP: Cursor와 Claude를 제품 제작 팀으로 바꾸는 방법
- Ansible Automation Orchestrator: 관리형 Control Plane 설계
참고 자료
- Run LoRA fine-tuning on Red Hat OpenShift AI with Ray
- Building hermetic notebook images for Open Data Hub and Red Hat OpenShift AI
- llm-d flow control: Priority queuing for shared GPU inference
- How AI observability works with MLflow
- GRPO fine-tuning on Red Hat OpenShift AI: Reinforcement learning from verifiable...
- LLM quantization guide: How to do it, and how it helps
- Orchestrate production RAG with OpenShift AI
- Stop wasting GPU allocation in Kubernetes with GPU-pruner
개발자가 주목해야 하는 이유
GPU가 할당됐다는 사실만으로 효율적인 사용이나 안정적인 응답을 보장할 수 없다. 비용과 서비스 품질을 함께 관리하려면 자원 회수, 요청 우선순위, 모델 아티팩트, 관측 가능성을 연계해야 한다.
권장 조치
- 1GPU 기반 추론 서비스 하나를 골라 사용률, 큐, 지연 시간, 장애, 출력 품질의 기준선을 만든 뒤 최적화 기법을 하나씩 독립적으로 시험한다.