빠른 요약
- Databricks는 복잡한 문서 추출을 Document Intelligence의 핵심 과제로 제시한다. 기업은 에이전트에 중요한 실행 권한을 주기 전에 비정형 문서를 통제된 워크플로에 연결할 수 있다.
- 문서는 업무 데이터를 시스템과 수작업 사이에 묶어 두는 경우가 많다. 검증 가능한 추출은 안전한 자동화의 기반이다.
- 반복되는 문서 유형 하나를 선정하고, 후속 실행 자동화 전에 예외 큐와 필수 검증 필드를 정의하세요.
무슨 일이 있었나
많은 기업 프로세스는 문서에서 시작해 읽기, 대조, 재입력, 전달 같은 수작업으로 끝난다. 따라서 document intelligence는 machine-learning과 에이전틱 AI를 도입할 현실적인 출발점이다. 다만 추출 결과를 곧바로 사실로 취급하지 않고 검증해야 한다.
Databricks Document Intelligence는 복잡한 문서에서의 추출을 다룬다. 이는 OCR만의 문제가 아니다. 문서 내용을 다음 시스템이 사용할 수 있는 구조화된 결과로 바꾸는 워크플로가 필요하다.
추출과 업무 의사결정을 분리하라
안전한 구조에는 최소 두 계층이 있다. 첫 계층은 필드, 표, 엔터티를 추출하고, 두 번째 계층은 데이터가 다음 단계로 가기 전에 완전성, 형식, 충돌, 신뢰 조건을 확인한다.
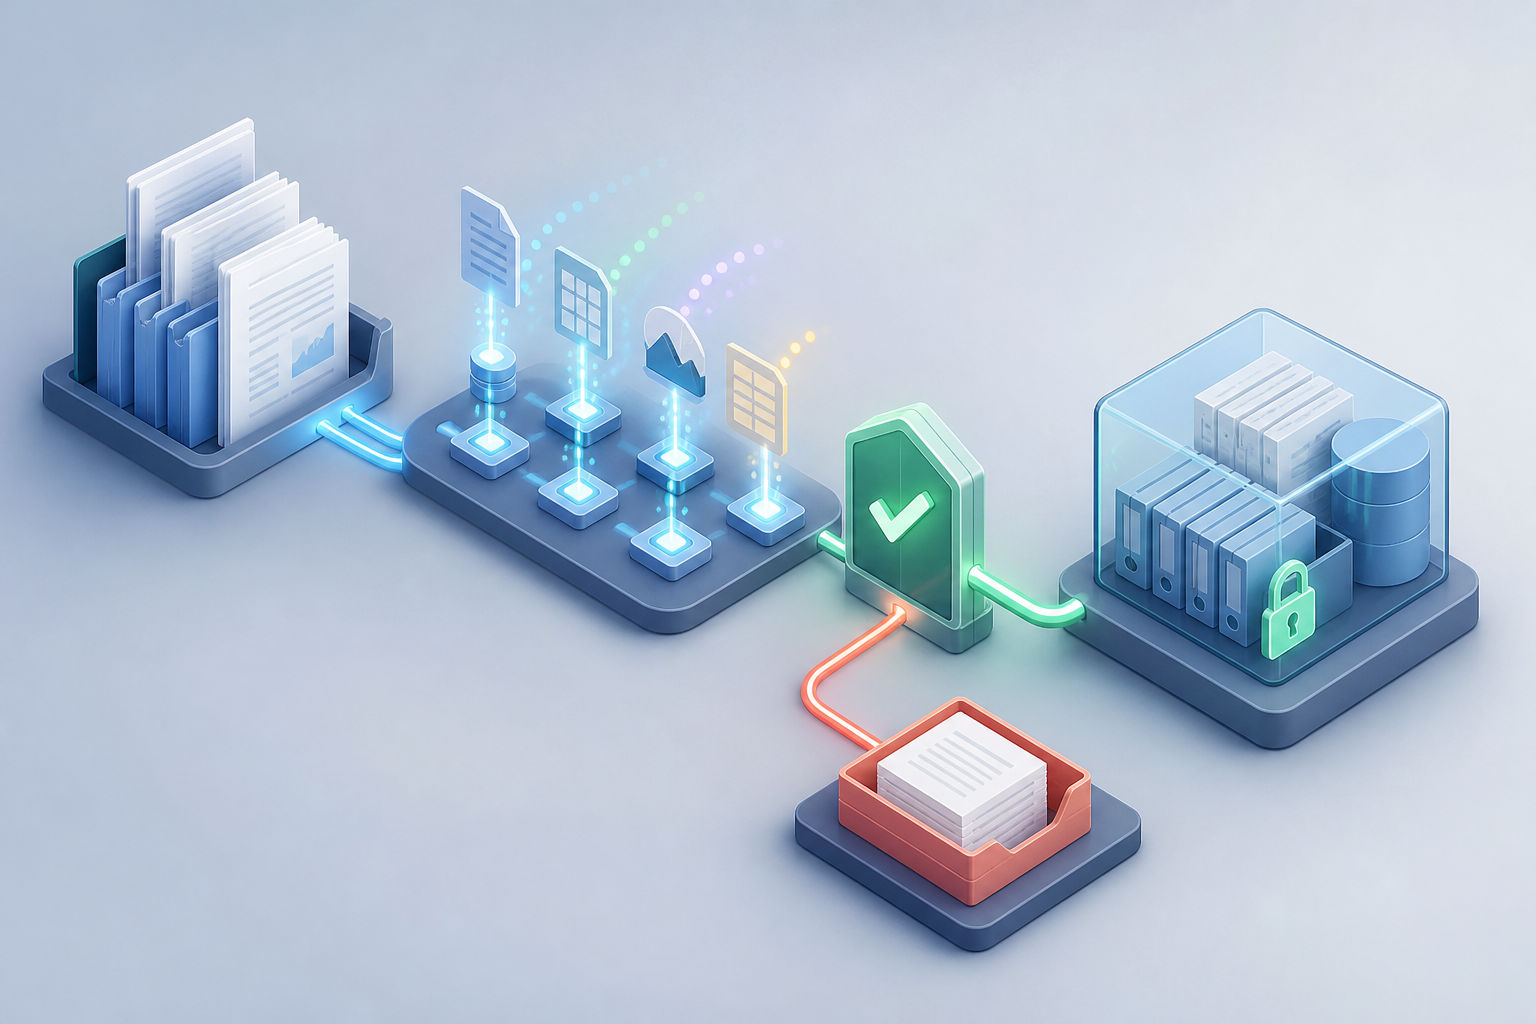
에이전트는 문서 분류, 처리 경로 선택, 예외 전달을 조율할 수 있다. 그러나 정책적 통제 없이 추론된 값을 되돌릴 수 없는 업무 시스템 변경으로 자동 전환해서는 안 된다.
예외 처리 경로를 먼저 설계하라
복잡한 문서는 누락 필드, 비정상 레이아웃, 상충 정보 같은 예외를 만든다. 좋은 파일럿은 평균 성공률 뒤에 이를 숨기지 않고 원본 문서, 추출 결과, 라우팅 이유, 검토자 결정을 보존한다.
이 기록은 어떤 문서 유형을 먼저 자동화할 수 있는지, 어떤 유형은 계속 검토가 필요한지 판단하게 한다. 감사 가능성을 유지한 채 프롬프트, 규칙, 평가 기준을 개선하는 근거도 된다.
다운스트림 영향으로 품질을 측정하라
추출 결과가 그럴듯해 보이는지만 보지 말아야 한다. 검증된 필드 비율, 예외 비율, 처리 시간, 후속 시스템까지 유입된 오류를 측정하라. 이 지표들이 모델 성능을 실제 운영 위험과 연결한다.
5분 요약
- Document intelligence는 복잡한 문서를 구조화된 워크플로 입력으로 바꾼다.
- 추출, 검증, 업무 실행을 분리해야 한다.
- 예외 처리에는 근거 보존과 사람의 검토 결정이 필요하다.
- 품질은 외관이 아니라 다운스트림 오류로 판단하라.
참고 자료
- Agentic Data Operations Platform (ADOP): Data engineering into hours
- Connecting retail demand planning to campaign and store execution
- Designing effective Genie Agents from a single prompt
- Databricks Document Intelligence: pushing the frontier for complex document extraction
- When it comes to Governance, Retailers need a control plane for context
개발자가 주목해야 하는 이유
문서는 업무 데이터를 시스템과 수작업 사이에 묶어 두는 경우가 많다. 검증 가능한 추출은 안전한 자동화의 기반이다.
권장 조치
- 1반복되는 문서 유형 하나를 선정하고, 후속 실행 자동화 전에 예외 큐와 필수 검증 필드를 정의하세요.