빠른 요약
- AI 에이전트는 사용자를 대신해 작업할 때마다 ID, 도구, 데이터, 인프라 경계를 넘는다. AWS의 구현 지침과 Wiz가 관찰한 공격 활동은 사용자부터 모델과 도구까지 이어지는 전체 경로에 보안 통제가 필요하다는 점을 보여준다.
- 모델 가드레일만으로는 과도한 데이터 접근, 도구 서버 침해, 자격 증명 탈취를 막을 수 없다. 각 도구 호출에 사용자 컨텍스트, 권한 결정, 입출력 검증과 감사 기록을 적용해야 한다.
- 운영 중인 에이전트 하나를 선택해 최초 principal부터 모든 도구와 데이터 저장소까지 경로를 그린 뒤, 권한 컨텍스트가 사라지거나 자격 증명을 과도하게 공유하거나 도구 출력을 검증하지 않는 첫 지점부터 개선한다.
무슨 일이 있었나
AI 에이전트는 자연어 요청을 데이터베이스 조회, 문서 검색, SaaS 연동, 내부 API 실행으로 바꾼다. 이 구조에서 모델은 보안 경계의 한 부분일 뿐이며, 권한 컨텍스트와 자격 증명, 도구 인자, 반환 데이터는 모델 수준 필터가 완전히 통제하지 못하는 시스템을 통과한다.
AWS의 보안 지침과 실제 공격 관찰 결과는 같은 공백을 가리킨다. AWS는 권한 전파, 사용자 지정 인증, 도구 가드레일 패턴을 제시했고, Wiz의 AI 인프라 허니팟은 LiteLLM, MCP 서버와 AI 프레임워크를 겨냥한 활동에서 원격 코드 실행(RCE), 블라인드 프롬프트 인젝션, 메모리 내 자격 증명 탈취를 관찰했다.
모델 가드레일만으로 충분하지 않은 이유
모델 경계의 가드레일은 모델에 들어가거나 모델에서 나오는 콘텐츠를 검사할 수 있다. 그러나 에이전트는 별도로 도구에 인자를 전달하고 외부 응답을 받아 여러 시스템 사이에서 데이터를 이동한다. AWS는 Strands Agents SDK로 Amazon Bedrock Guardrails를 도구 상호작용까지 확장하는 지침에서 모델 밖의 흐름을 검증하기 위한 세 개 체크포인트 구현을 다룬다.
여기서 콘텐츠 안전성과 실행 보안의 차이가 드러난다. 최종 답변이 무해해 보여도 요청자가 읽을 권한이 없는 데이터로 작성됐을 수 있다. 반대로 문법적으로 정상인 도구 호출에도 프롬프트 인젝션이 유도한 위험한 인자가 포함될 수 있다.
MCP나 게이트웨이 자체를 신뢰 경계로 간주해서도 안 된다. 연동 방식을 표준화하고 중개할 수는 있지만, 서버와 프레임워크, 하위 시스템의 자격 증명은 여전히 공격 표면이다. MCP 기반 개발 도구 모음을 구성한다면 모델뿐 아니라 에이전트에 공개하는 각 기능을 대상으로 위협 모델링해야 한다.
다층 에이전트 보안은 무엇을 통제해야 하나?
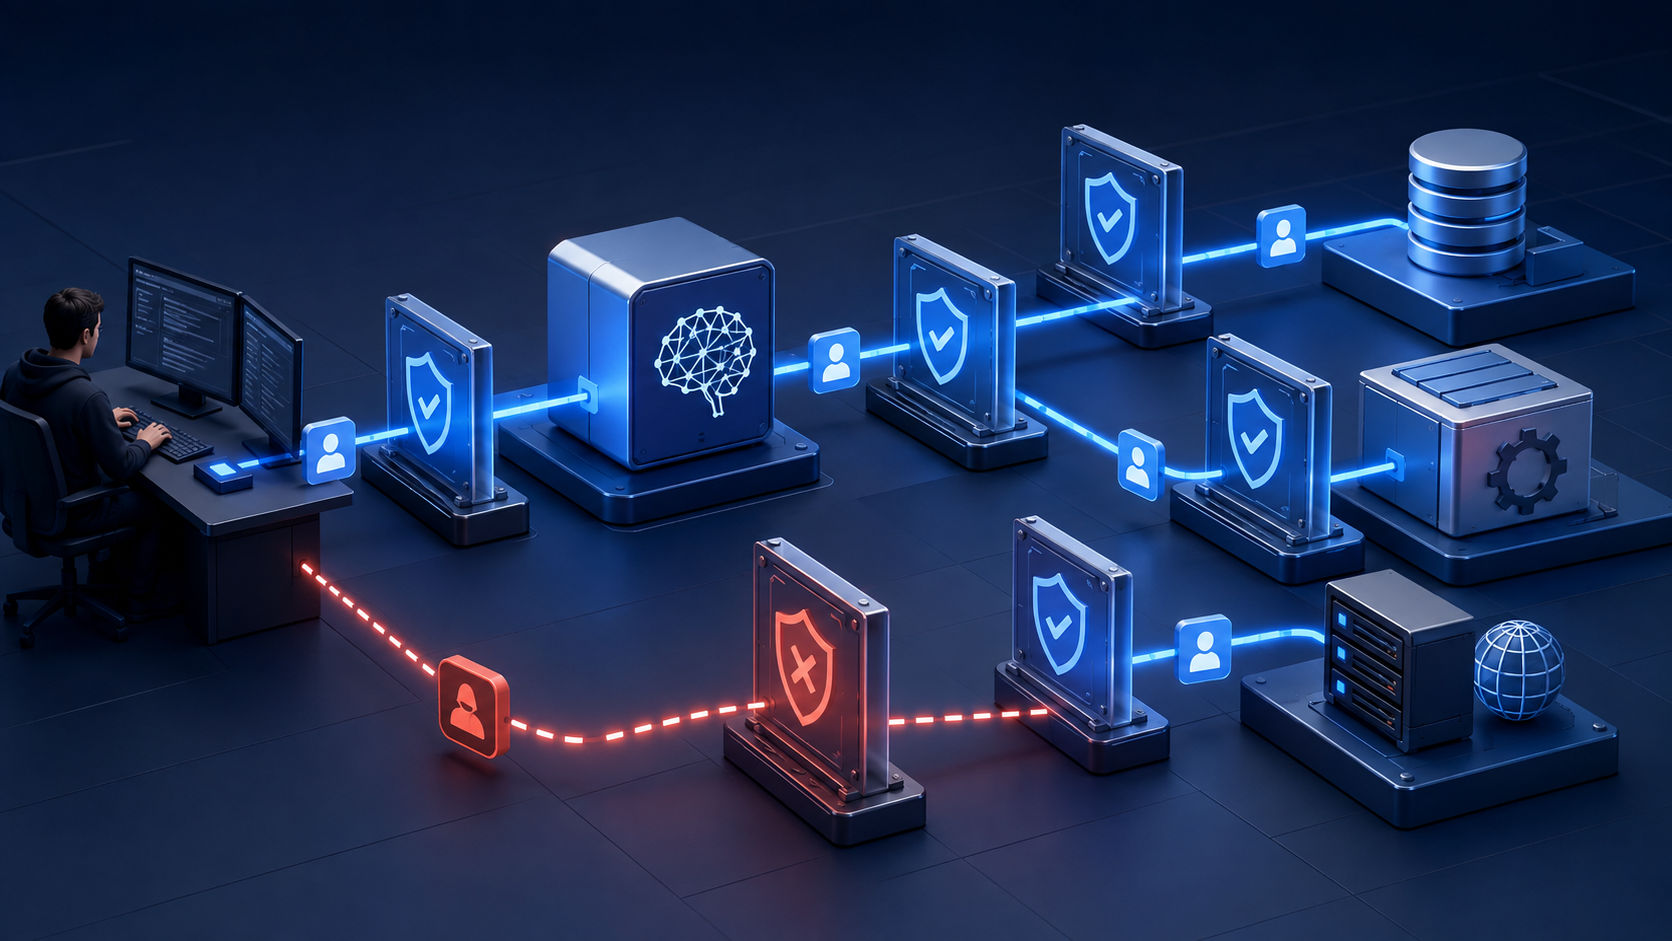
실용적인 설계 원칙은 에이전트 체인의 각 단계를 신뢰 경계 통과로 취급하는 것이다. ID 컨텍스트는 체인 끝까지 유지하되, 실제 권한은 모델의 판단을 신뢰하지 말고 리소스를 소유한 구성 요소에서 다시 평가해야 한다.
| 계층 | 주요 위험 | 우선 통제 |
|---|---|---|
| 사용자에서 에이전트 | 호출자 컨텍스트 누락 또는 위조 | 사용자 인증, principal과 권한 속성 보존 |
| 에이전트에서 도구 | 잘못된 도구 선택 또는 위험한 인자 | 도구 allowlist, 스키마 검증, 작업 단위 정책 |
| 도구에서 데이터 | 권한 없는 조회 또는 변경 | 리소스 계층 권한 검사, 최소 권한, 범위 제한 |
| 도구 응답 | 악성 콘텐츠나 민감 데이터의 컨텍스트 유입 | 출력 검증, 데이터 필터링, 컨텍스트 제한 |
| 런타임과 게이트웨이 | RCE, secret 노출, 서비스 장악 | 패치, 격리, secret 관리, 행위 모니터링 |
AgentCore에서 사용자 권한 컨텍스트를 전파하는 AWS 패턴은 호출자가 누구인지 모르는 에이전트가 해당 사용자에게 허용되지 않은 데이터를 반환할 수 있다는 설계 문제를 다룬다. 일반화하면 정책을 결정하는 목적지까지 충분한 ID 컨텍스트를 전달하되, 모든 사용자를 광범위한 권한의 단일 서비스 ID로 치환하지 않아야 한다.
인증과 인가도 분리해야 한다. OAuth 2.0, IAM 또는 API key는 ID를 확인하거나 대신 표현할 수 있지만, 그 ID가 어떤 도구를 호출하고 어떤 리소스에 무슨 작업을 수행할 수 있는지는 별도의 정책이 결정해야 한다.
개발팀은 어디서부터 적용해야 하나?
우선 에이전트가 호출할 수 있는 모든 도구를 목록화해야 한다. 읽기와 쓰기, 되돌릴 수 없는 작업을 구분하고, 각 도구에 사용되는 principal, 입출력 데이터, 권한 집행 지점, 관련 secret, 보존해야 할 감사 이벤트를 기록한다.
- ID를 종단 간 전달한다: 에이전트 런타임, 게이트웨이, 어댑터를 지나는 동안 사용자 컨텍스트를 유지하고 필수 정보가 없으면 요청을 거부한다.
- 권한을 줄인다: 조회 도구와 상태 변경 도구를 분리하고 리소스 범위를 제한하며 모든 세션이 하나의 강력한 자격 증명을 공유하지 않게 한다.
- 실행 전후를 검증한다: 선택된 도구와 인자의 타입, 범위, 스코프를 확인하고 반환 데이터를 모델 컨텍스트에 넣기 전에 검사한다.
- 인프라를 격리한다: LiteLLM, MCP 서버, 플러그인과 에이전트 프레임워크를 단순 미들웨어가 아니라 침해될 수 있는 워크로드로 운영한다.
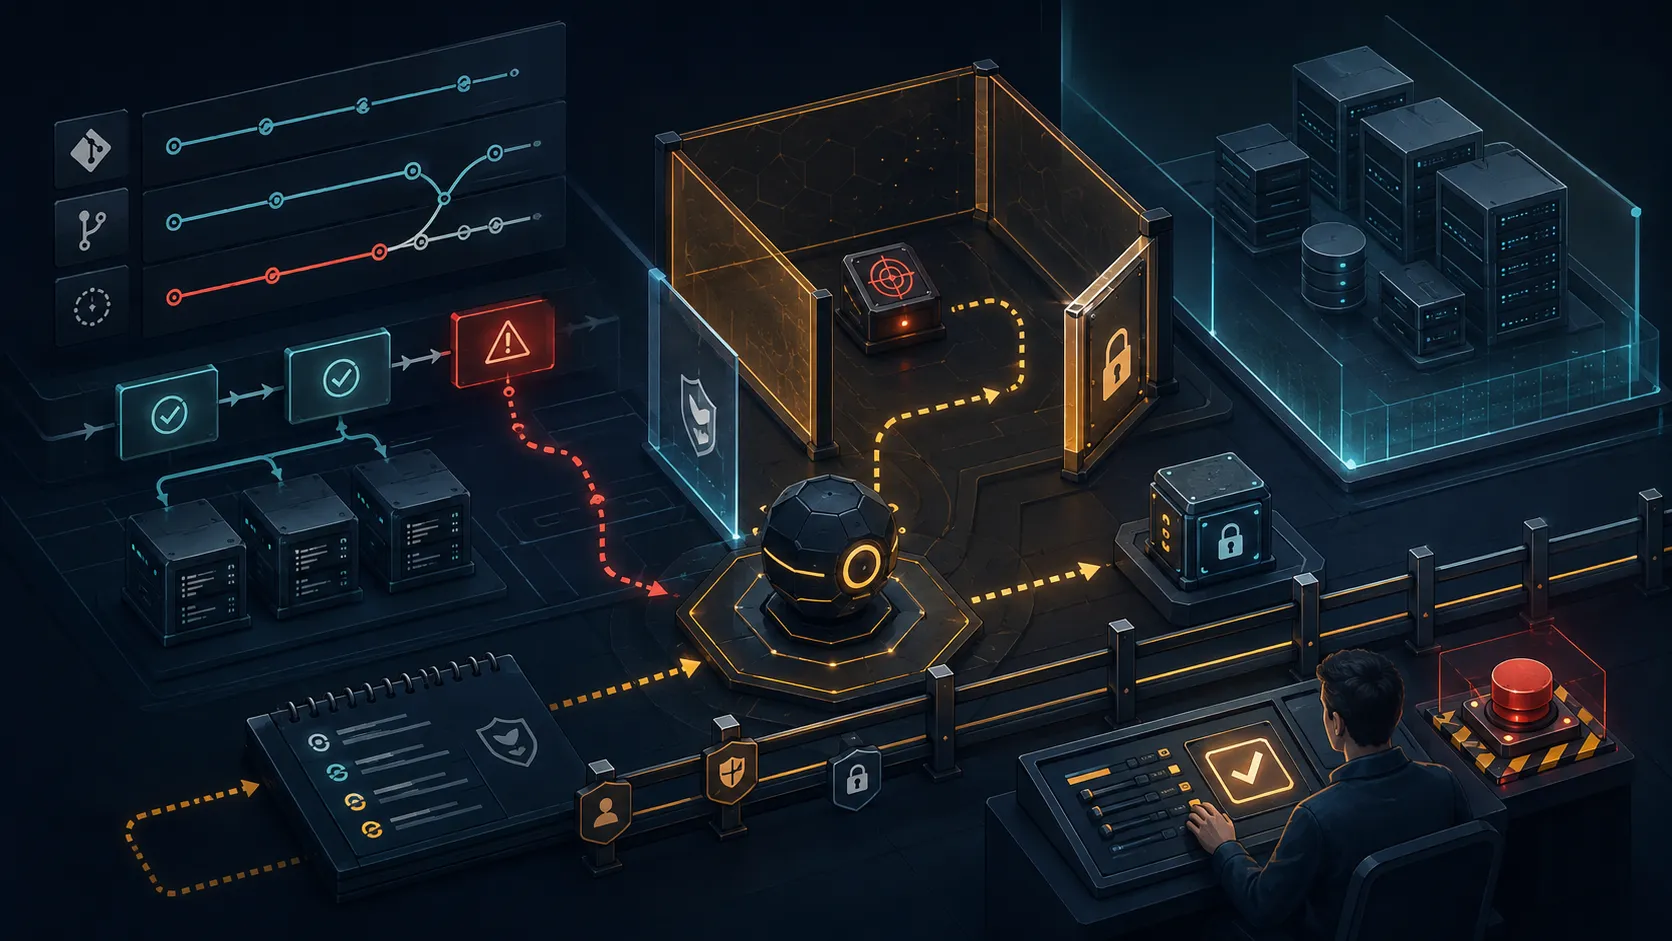
- 결정을 기록한다: secret이나 민감한 payload를 과도하게 저장하지 않으면서 principal, 도구, 적용 정책, 결과와 상관관계 ID를 남긴다.
기업 환경에서는 RFC 7617의 HTTP Basic Authentication을 사용하는 기존 서비스와 연동해야 할 수도 있다. AWS의 AgentCore Gateway 예시는 request Lambda interceptor로 사용자 지정 인증을 처리하는 방식을 OAuth 2.0, IAM, API key 지원과 함께 설명한다. 다만 interceptor는 호환성 경계일 뿐이며 전송 구간 보호, secret 보관과 교체, 최소 권한을 대신하지 않는다.
이러한 통제는 프롬프트마다 임의로 복제하기보다 담당자와 정책이 명확한 control plane에서 관리하는 편이 낫다. 이는 관리형 자동화 control plane 설계와도 맞닿아 있다. 정책은 일관되게 관리하고 분산된 실행은 감사 가능하게 만들어야 한다.
앞으로 무엇을 테스트하고 모니터링해야 하나?
에이전트 레드팀 테스트는 금지된 답변을 생성하도록 모델을 유도하는 데서 멈추면 안 된다. 낮은 권한의 사용자가 높은 권한의 데이터를 요청하는 경우, 외부 문서에 숨은 지시가 있는 경우, 스키마 밖의 도구 인자, 다음 에이전트 단계를 조종하려는 도구 응답, 런타임 메모리에서 자격 증명이 노출되는 경우를 전체 체인에서 시험해야 한다.
운영 단계에서는 특정 principal의 비정상적인 도구 사용, 호출 횟수 급증, 예상 범위를 벗어난 인자, 작업 목적과 맞지 않는 대량 데이터 접근을 탐지해야 한다. 로그는 사용자–에이전트–도구–리소스 경로를 재구성할 수 있어야 하지만, 관측 시스템 자체가 자격 증명과 민감 데이터 저장소가 되지 않도록 해야 한다.
AWS 자료는 특정 클라우드 생태계를 위한 구현 패턴이고 Wiz 보고서는 자사 허니팟에서 관찰한 활동을 설명한다. 모든 에이전트 스택에서 동일한 침해가 발생한다는 의미는 아니지만, 모델 밖의 통제를 지금 점검해야 할 근거로는 충분하다.
결론
- 모델 가드레일은 에이전트 워크플로의 한 구간만 보호한다.
- 사용자 ID와 권한 결정은 데이터나 작업을 소유한 시스템까지 전달돼야 한다.
- 게이트웨이, MCP 서버와 AI 프레임워크를 민감한 인프라로 운영해야 한다.
- 도구 목록화, 최소 권한, 검증 체크포인트와 감사 가능한 로그를 우선 적용해야 한다.
관련 글
- Ventura React: 이 경량 컴포넌트 라이브러리는 새 프로젝트에도 적합할까?
- Nova MCP: Cursor와 Claude를 제품 제작 팀으로 바꾸는 방법
- Ansible Automation Orchestrator: 관리형 Control Plane 설계
참고 자료
- Propagate user authorization context in AI agents with Amazon Bedrock AgentCore
- Implement custom authentication for tools integration using request Lambda interceptor in AgentCore Gateway
- Extend Amazon Bedrock Guardrails to Tool Interactions Using the Strands Agents SDK
- Inside 90 days of attacks on AI infrastructure
개발자가 주목해야 하는 이유
모델 가드레일만으로는 과도한 데이터 접근, 도구 서버 침해, 자격 증명 탈취를 막을 수 없다. 각 도구 호출에 사용자 컨텍스트, 권한 결정, 입출력 검증과 감사 기록을 적용해야 한다.
권장 조치
- 1운영 중인 에이전트 하나를 선택해 최초 principal부터 모든 도구와 데이터 저장소까지 경로를 그린 뒤, 권한 컨텍스트가 사라지거나 자격 증명을 과도하게 공유하거나 도구 출력을 검증하지 않는 첫 지점부터 개선한다.