Tóm tắt nhanh
- Làn sóng công cụ mới quanh LangSmith cho thấy kỹ thuật AI agent đang vượt ra ngoài việc chọn mô hình, tập trung nhiều hơn vào đánh giá, phát hiện sự cố và kiểm thử trước khi phát hành. Môi trường tác vụ, agent harness và bộ nhớ tự sửa lỗi cũng trở thành những phần quan trọng của hệ thống production.
- Độ tin cậy của agent phụ thuộc vào toàn bộ hệ thống bao quanh mô hình. Nhóm phát triển cần đo hành vi, cô lập thay đổi, kiểm soát trạng thái và phát hiện lỗi trước khi mở rộng triển khai.
- Chọn một workflow agent có phạm vi hẹp, xây dựng tập tác vụ hồi quy từ lỗi thực tế và thử nghiệm preview, evaluator cùng trace production trước khi mở rộng triển khai.
Điều gì đã xảy ra
Việc chọn mô hình mạnh hơn không còn là câu trả lời đầy đủ cho bài toán đưa AI agent vào production. Các cập nhật gần đây quanh LangSmith đặt trọng tâm vào một lớp kỹ thuật ít hào nhoáng hơn nhưng thiết yếu: đánh giá hành vi, thử nghiệm thay đổi, phát hiện sự cố và quản lý trạng thái.
Đây chưa phải bằng chứng cho thấy mọi vấn đề về độ tin cậy của agent đã được giải quyết. Tuy nhiên, chuỗi công bố cho thấy thị trường đang chuyển từ những bản demo dựa trên prompt sang quy trình có thể đo lường, kiểm soát và vận hành lâu dài.
Điều gì đang thay đổi trong bộ công cụ dành cho agent?
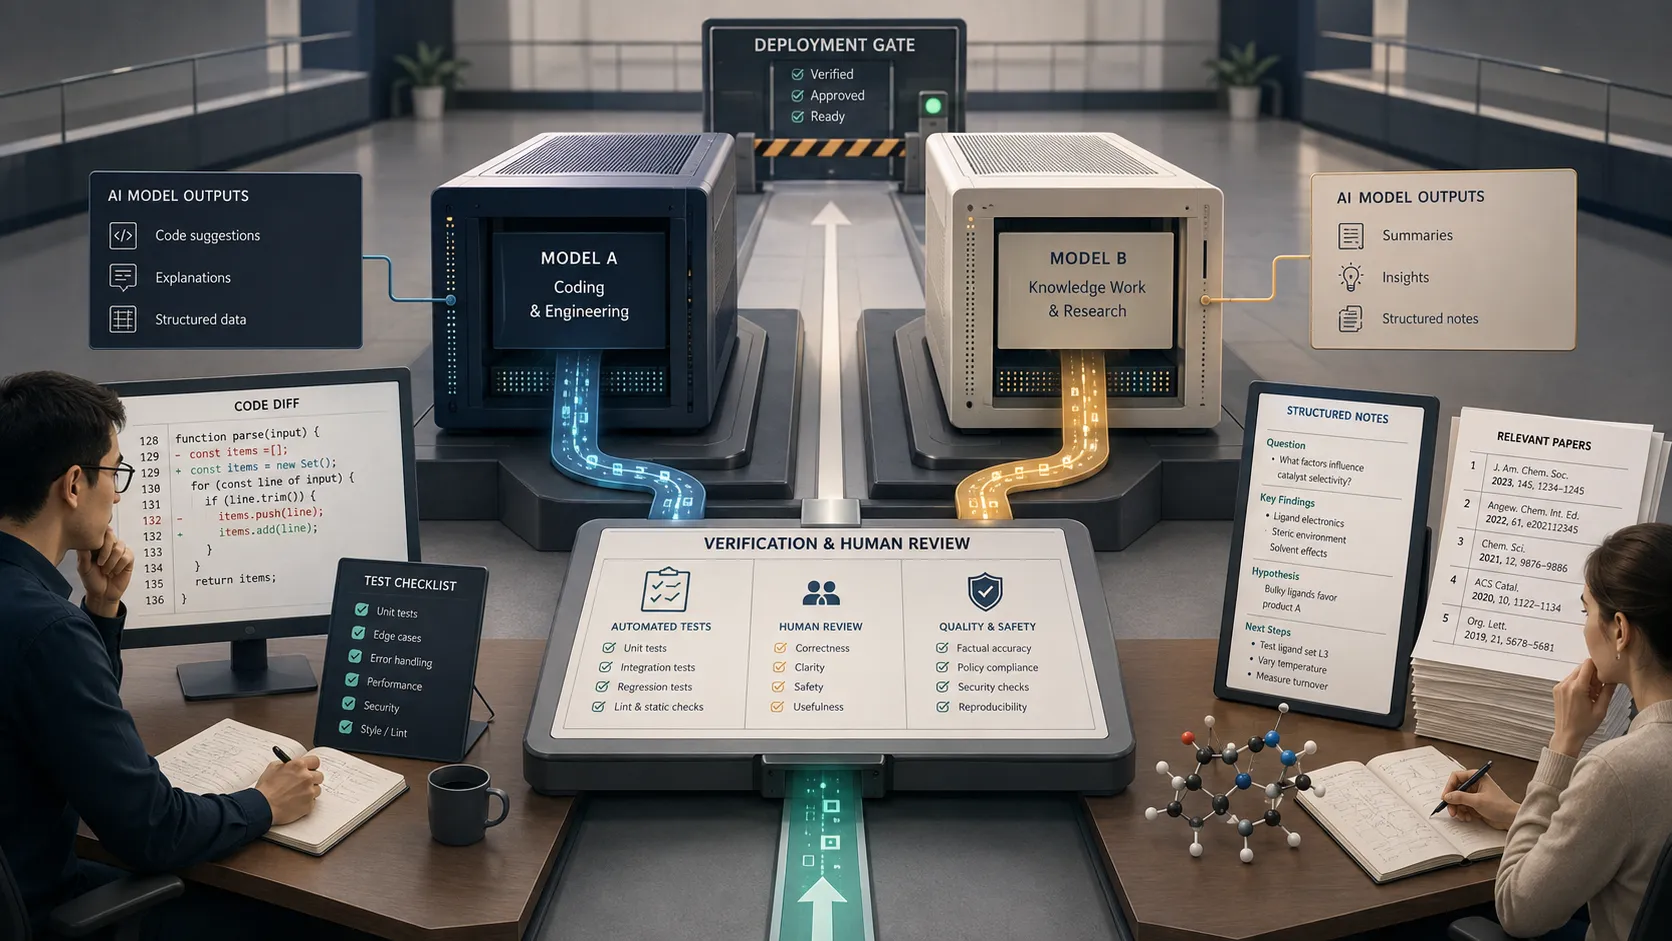
LangChain công bố một loạt khả năng giải quyết các giai đoạn khác nhau của vòng đời agent. LangSmith Preview Builds được giới thiệu để kiểm thử thay đổi trước khi đưa vào production, tạo ra ranh giới rõ hơn giữa thử nghiệm và phiên bản đang phục vụ người dùng.
Ở lớp đánh giá, Tuned Evaluators bắt đầu với Perceived Error, hướng tới việc nhận diện lỗi như người dùng cảm nhận thay vì chỉ dựa vào kiểm tra đầu ra cố định. Trong khi đó, LangChain tuyên bố LangSmith Engine cải thiện hơn hai lần khả năng phát hiện sự cố. Đây là số liệu do nhà cung cấp công bố, không nên xem như benchmark độc lập áp dụng cho mọi workload.
Một nghiên cứu tình huống khác mô tả cách Toyota North America sử dụng deep agents và LangSmith cho AI doanh nghiệp. Bằng chứng công khai được cung cấp ở đây chưa đủ để suy rộng hiệu quả sang tổ chức khác, nhưng nó cho thấy quan sát và đánh giá đang được định vị như thành phần của triển khai doanh nghiệp, không chỉ là công cụ gỡ lỗi khi phát triển.
Vì sao mô hình không còn là đơn vị kỹ thuật duy nhất?
Một agent không chỉ tạo ra một câu trả lời. Nó nhận trạng thái, lựa chọn công cụ, thực hiện nhiều bước, quan sát kết quả và có thể ghi thông tin vào bộ nhớ. Lỗi vì thế có thể xuất phát từ prompt, dữ liệu, quyền truy cập công cụ, môi trường tác vụ, logic điều phối hoặc trạng thái cũ chứ không nhất thiết từ mô hình.
Khái niệm agent harness mô tả lớp bao quanh mô hình: chỉ dẫn, công cụ, vòng lặp thực thi, xử lý lỗi, giới hạn và cơ chế quan sát. Một bài viết thứ cấp về vai trò của harness lập luận rằng lớp này đang trở thành yếu tố khác biệt quan trọng. Đây là một cách diễn giải đáng chú ý, nhưng các nhóm vẫn cần kiểm chứng trên tác vụ và ràng buộc của chính mình.
Thiết kế môi trường đánh giá cũng quan trọng tương tự. LangChain đã mô tả cách xây dựng môi trường và tác vụ cho agent, nhấn mạnh rằng chất lượng phép thử phụ thuộc vào bối cảnh mà agent được phép hành động. Nếu môi trường thử nghiệm quá đơn giản hoặc khác xa production, điểm đánh giá cao vẫn có thể tạo ra cảm giác an toàn giả.
Một control plane cho agent nên đo những gì?
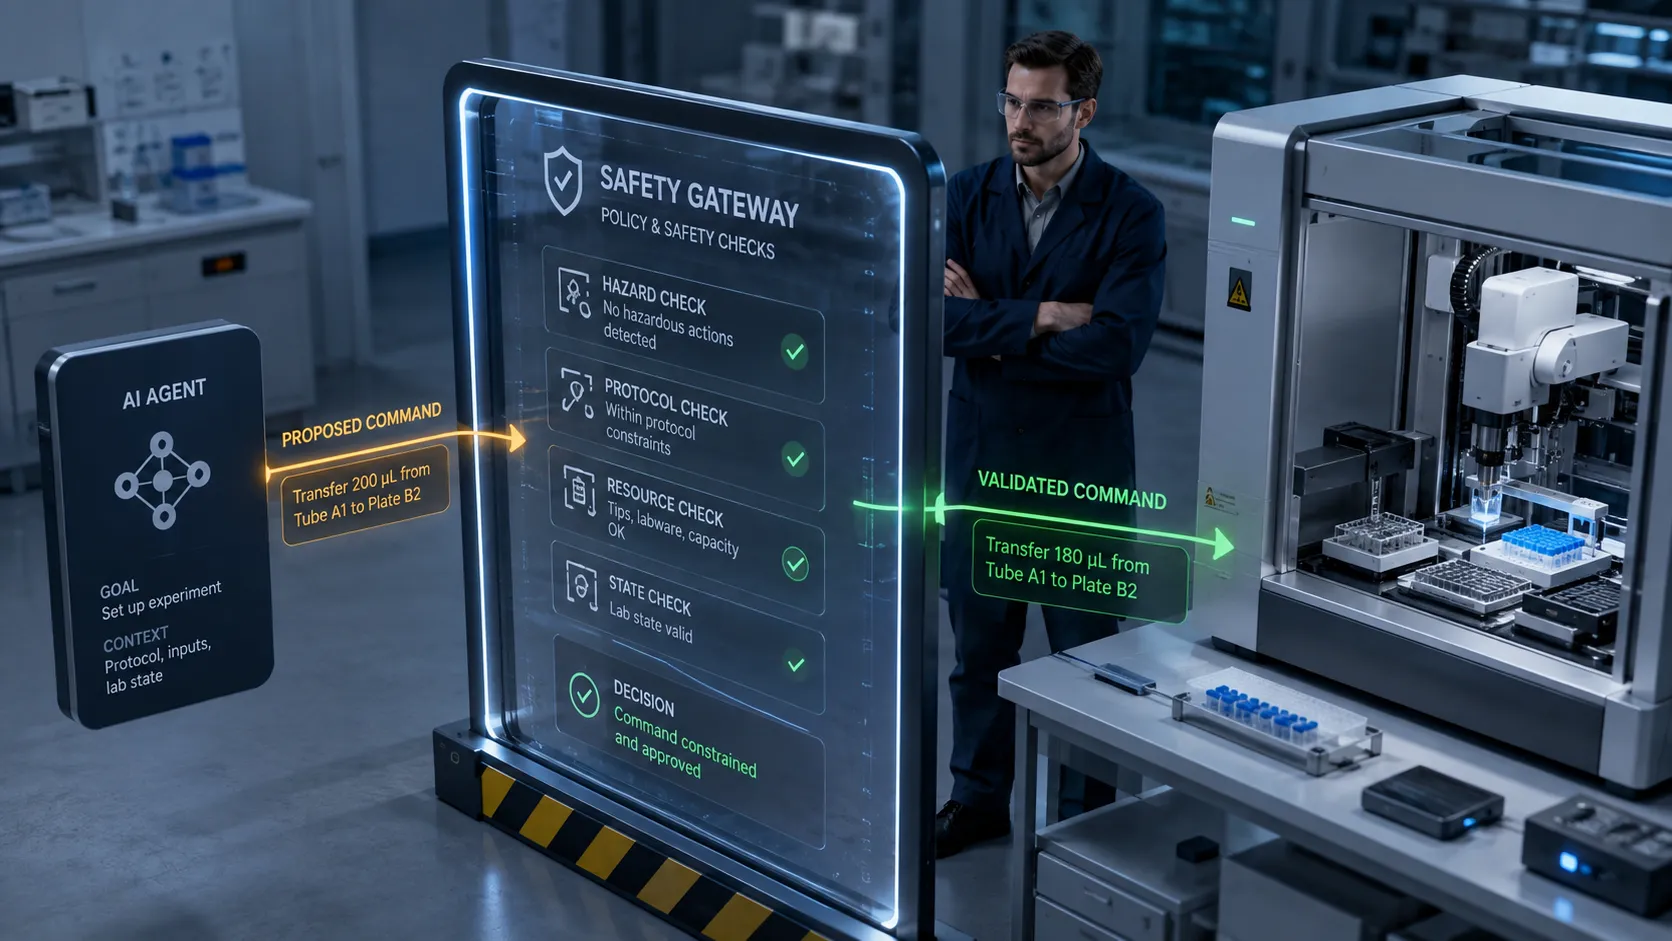
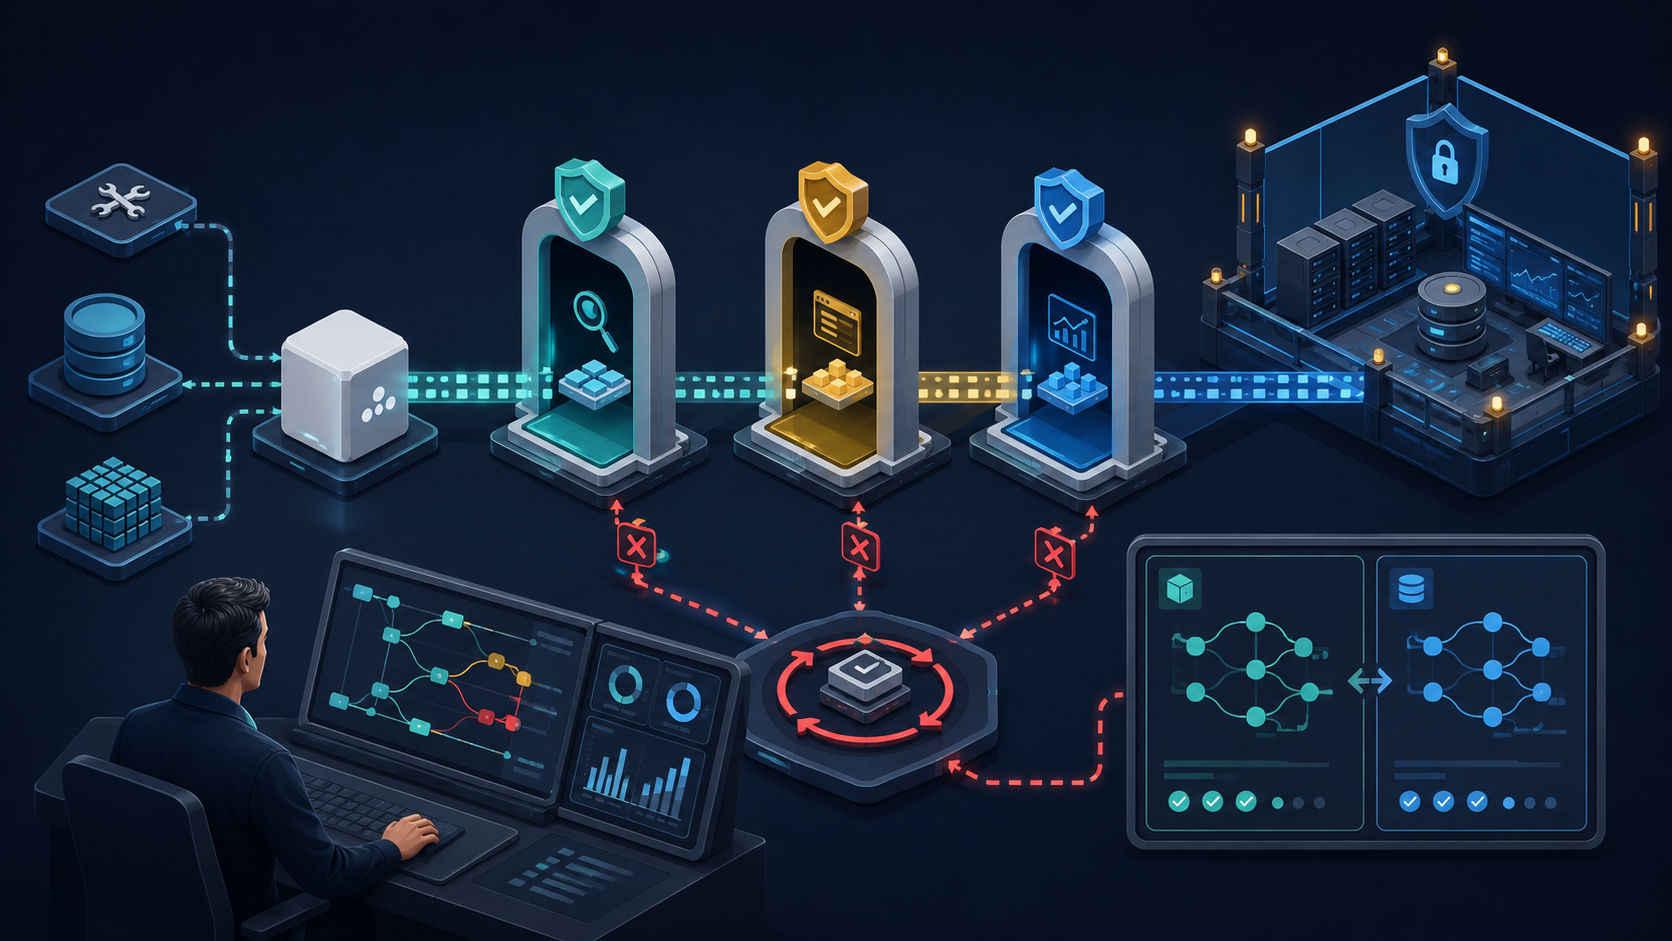
Đối với nhóm phát triển, cách tiếp cận thực tế là tách hệ thống đảm bảo chất lượng thành nhiều lớp. Đây là khuyến nghị kiến trúc, không phải tuyên bố rằng một sản phẩm đơn lẻ đã tự động giải quyết toàn bộ các lớp này.
| Lớp kiểm soát | Câu hỏi cần trả lời | Tín hiệu nên lưu |
|---|---|---|
| Thay đổi | Phiên bản mới khác bản đang chạy ở đâu? | Prompt, cấu hình, model, công cụ và tập kiểm thử |
| Hành vi | Agent có hoàn thành đúng nhiệm vụ không? | Kết quả, đường đi công cụ, lỗi cảm nhận và tiêu chí tác vụ |
| Runtime | Lỗi nào chỉ xuất hiện trong lưu lượng thực? | Trace, ngoại lệ, phản hồi người dùng và các trường hợp bất thường |
| Trạng thái | Bộ nhớ có tích lũy thông tin sai hay lỗi thời không? | Nguồn gốc dữ liệu, thay đổi bộ nhớ và kết quả xác minh |
Bộ nhớ cần được coi là trạng thái có thể kiểm tra thay vì kho dữ liệu luôn đúng. Bài viết về bộ nhớ tự sửa lỗi trong OpenWiki cho thấy hướng tiếp cận trong đó hệ thống có cơ chế xem xét và điều chỉnh tri thức đã lưu. Từ góc độ kỹ thuật, câu hỏi quan trọng không chỉ là agent nhớ được bao nhiêu, mà còn là lỗi được phát hiện, truy nguyên và sửa như thế nào.
Tư duy control plane này gần với cách các nền tảng vận hành truyền thống tách hoạt động quản trị khỏi workload. Độc giả xây dựng hệ thống nhiều công cụ có thể tham khảo thêm các nguyên tắc trong thiết kế control plane có quản trị, dù cơ chế cụ thể của agent và hạ tầng tự động hóa không hoàn toàn giống nhau.
Nhóm phát triển nên áp dụng theo lộ trình nào?
Không nên bắt đầu bằng việc mua thêm công cụ rồi mới xác định cần đo gì. Hãy chọn một workflow agent có giá trị nhưng phạm vi giới hạn, thu thập các lỗi đã biết và chuyển chúng thành tập tác vụ có thể chạy lại. Mỗi tác vụ nên có điều kiện khởi tạo, quyền công cụ và tiêu chí thành công đủ rõ để so sánh các phiên bản.
- Thiết lập đường cơ sở: lưu kết quả, trace và lỗi của phiên bản hiện tại trên một tập tác vụ đại diện.
- Cô lập thay đổi: kiểm thử riêng các thay đổi về prompt, model, công cụ hoặc bộ nhớ trước khi phát hành.
- Kết hợp phép đo: dùng kiểm tra xác định khi có thể, evaluator cho tiêu chí khó mã hóa và đánh giá của con người cho trường hợp rủi ro cao.
- Đóng vòng phản hồi: đưa sự cố production đã xác nhận trở lại tập hồi quy và theo dõi nguồn gốc của dữ liệu bộ nhớ.
- Đặt ngưỡng phát hành: chỉ mở rộng khi chất lượng, chi phí và hành vi lỗi đáp ứng tiêu chí đã thống nhất.
Các nhóm dùng agent để phối hợp nhiều công cụ cũng nên kiểm tra quyền hạn và điểm bàn giao, không chỉ chất lượng văn bản. Ví dụ, mô hình tổ chức nhiều AI thành một quy trình sản phẩm trong workflow dựa trên MCP làm tăng nhu cầu về trace, ranh giới trách nhiệm và kiểm thử tích hợp.
Cần theo dõi liệu các tuyên bố về cải thiện phát hiện sự cố có được xác nhận trên dữ liệu đa dạng hơn hay không, evaluator đã tinh chỉnh có ổn định giữa miền nghiệp vụ hay không, và preview build có phản ánh đủ điều kiện production hay không. Đây là các tiêu chí đánh giá thực tế hơn so với số lượng tính năng hoặc chất lượng của một bản demo.
Kết luận
- Kỹ thuật AI agent đang dịch chuyển từ chọn mô hình sang kiểm soát toàn bộ vòng đời.
- Preview testing, evaluation và quan sát runtime giải quyết những loại rủi ro khác nhau.
- Harness, môi trường tác vụ và bộ nhớ phải được kiểm thử như các thành phần độc lập.
- Nên đánh giá các công cụ mới bằng lỗi production thực tế và tập hồi quy của chính tổ chức.
Bài viết liên quan
- Ventura React: thư viện component nhẹ còn phù hợp cho dự án mới?
- Nova MCP: Biến AI trong Cursor và Claude thành đội ngũ sản phẩm
- Ansible Automation Orchestrator: thiết kế control plane có quản trị
Nguồn tham khảo
- How Toyota North America Put Enterprise AI on the Balance Sheet with Deep Agents and LangSmith
- New in LangSmith Engine: >2x better issue detection
- How We Build Agent Environments & Tasks
- Building Self-Correcting Memory in OpenWiki
- Introducing LangSmith Tuned Evaluators, starting with Perceived Error
- LangSmith Preview Builds: Test agent changes before production
- Nvidia just showed that the harness, not the AI model, is now the real hero
Vì sao developer cần quan tâm
Độ tin cậy của agent phụ thuộc vào toàn bộ hệ thống bao quanh mô hình. Nhóm phát triển cần đo hành vi, cô lập thay đổi, kiểm soát trạng thái và phát hiện lỗi trước khi mở rộng triển khai.
Hành động đề xuất
- 1Chọn một workflow agent có phạm vi hẹp, xây dựng tập tác vụ hồi quy từ lỗi thực tế và thử nghiệm preview, evaluator cùng trace production trước khi mở rộng triển khai.