Tóm tắt nhanh
- Anthropic giới thiệu Claude Fable 5.1 và Claude Mythos 5.1 là các mô hình tiên tiến dành cho lập trình và công việc tri thức. Thông tin hiện có chưa nêu benchmark, API, giá hay giới hạn ngữ cảnh, vì vậy đội ngũ kỹ thuật nên chờ tài liệu chi tiết và tự đánh giá trên workload thực tế.
- Nếu các tuyên bố được kiểm chứng, hai mô hình có thể tác động đến cách đội ngũ xây trợ lý lập trình, quy trình nghiên cứu và agent. Tuy nhiên, quyết định production cần dựa trên benchmark nội bộ, khả năng kiểm soát và chi phí toàn hệ thống.
- Theo dõi tài liệu API, giá, giới hạn và benchmark chính thức; đồng thời chuẩn bị bộ đánh giá từ repository và tài liệu nội bộ trước khi thử nghiệm có kiểm soát.
Điều gì đã xảy ra
Anthropic đã công bố Claude Fable 5.1 và Claude Mythos 5.1, mô tả đây là những mô hình tiên tiến nhất của hãng cho lập trình và công việc tri thức. Hãng cũng cho rằng năng lực nghiên cứu của chúng hé lộ cách AI có thể đóng góp vào tiến bộ khoa học.
Đó là một định hướng đáng chú ý, nhưng tài liệu được cung cấp chỉ xác nhận các tuyên bố cấp cao. Chưa có đủ dữ liệu để kết luận mô hình nào phù hợp hơn với từng workload, mức cải thiện thực tế ra sao hoặc chi phí triển khai có hợp lý hay không.
Anthropic thực sự đã công bố điều gì?
Trong thông báo về Claude Fable 5.1 và Claude Mythos 5.1, Anthropic gắn cả hai mô hình với ba phạm vi chính: viết và xử lý mã, công việc tri thức, cùng nghiên cứu. Phần mô tả nghiên cứu được đặt trong bối cảnh tiềm năng đóng góp cho khoa học, không phải bằng chứng rằng các mô hình đã tự tạo ra một đột phá khoa học cụ thể.
Nguồn hiện có không cung cấp kiến trúc, kích thước mô hình, cửa sổ ngữ cảnh, giá, độ trễ, khu vực cung cấp hoặc phương thức truy cập. Nó cũng không xác định sự phân vai giữa Fable 5.1 và Mythos 5.1, nên chưa thể giả định một mô hình nhanh hơn, rẻ hơn hay mạnh hơn mô hình còn lại.
| Đã được nêu | Chưa được xác nhận trong tài liệu cung cấp |
|---|---|
| Hai tên mô hình và phiên bản 5.1 | API, SDK và thời điểm khả dụng |
| Định hướng cho coding và knowledge work | Benchmark, độ trễ và giá |
| Tuyên bố về năng lực nghiên cứu | Giới hạn ngữ cảnh, tool use và tính năng agent |
| Tiềm năng hỗ trợ tiến bộ khoa học | Kết quả khoa học đã được kiểm chứng độc lập |
Khoảng trống này không đồng nghĩa sản phẩm thiếu các khả năng đó; nó chỉ có nghĩa chúng chưa thể được xác nhận từ bằng chứng hiện có. Với người mua nền tảng AI, đây là ranh giới quan trọng giữa thông báo sản phẩm và quyết định kiến trúc.
Vì sao trọng tâm coding, knowledge work và research đáng chú ý?
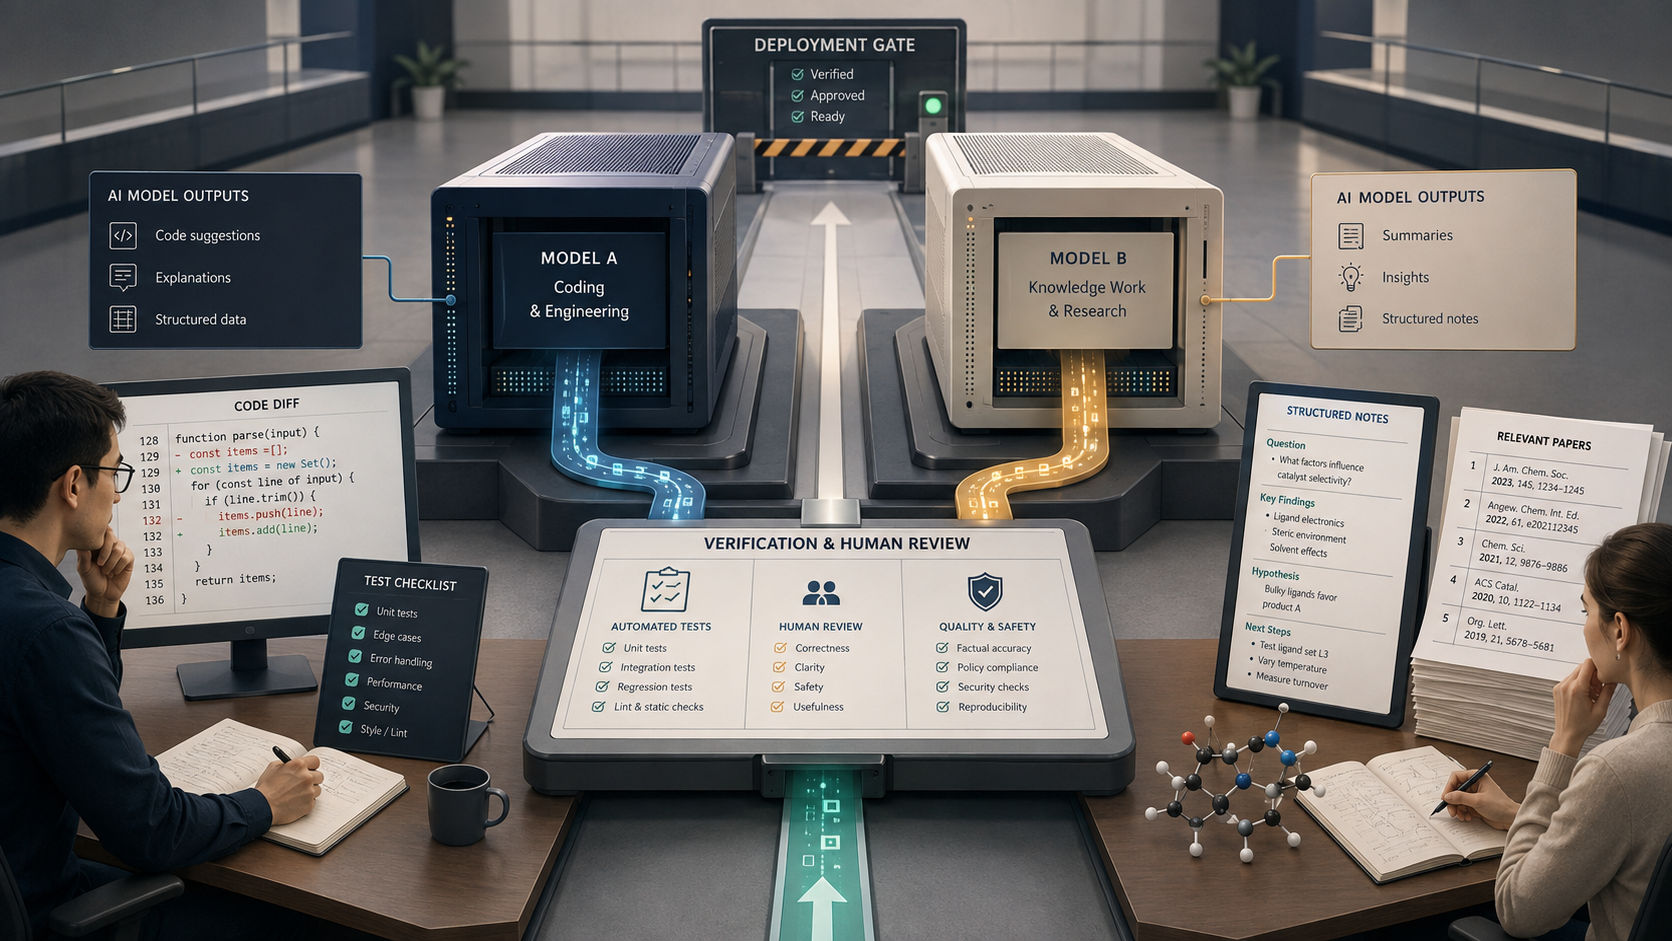
Ba nhóm công việc có một điểm chung: đầu ra thường phải dựa trên nhiều ngữ cảnh và có thể được kiểm tra. Mã có thể qua test và review; tài liệu có thể đối chiếu với nguồn; còn kết quả nghiên cứu cần được tái lập hoặc thẩm định bởi chuyên gia.
Vì thế, giá trị của mô hình không chỉ nằm ở việc tạo câu trả lời trôi chảy. Một hệ thống hữu ích phải duy trì đúng yêu cầu, làm việc với dữ liệu liên quan và tạo đầu ra mà con người hoặc công cụ có thể xác minh. Đây là diễn giải về yêu cầu triển khai, không phải tính năng đã được Anthropic xác nhận cho hai mô hình.
Đối với lập trình, bài kiểm tra có ý nghĩa nên bao gồm sửa lỗi trong repository thật, thay đổi nhiều tệp, tuân thủ convention và vượt qua test. Với công việc tri thức, đội ngũ nên đo khả năng trích dẫn đúng, xử lý tài liệu dài và thừa nhận khi thiếu bằng chứng. Với nghiên cứu, tiêu chuẩn cần cao hơn: nguồn gốc dữ liệu, khả năng tái lập và đánh giá của chuyên gia vẫn là lớp kiểm soát bắt buộc.
Đội ngũ phát triển nên đánh giá hai mô hình như thế nào?
Không nên thay mô hình production chỉ dựa trên cụm từ “tiên tiến nhất”. Hãy xây một tập đánh giá nhỏ từ tác vụ thật, giữ cố định prompt, ngữ cảnh, công cụ và tiêu chí chấm điểm, sau đó so sánh với hệ thống hiện tại.
- Chất lượng: tỷ lệ test vượt qua, độ chính xác của thay đổi và số lỗi cần con người sửa.
- Độ tin cậy: mức biến động giữa nhiều lần chạy, xử lý đầu vào thiếu dữ liệu và khả năng từ chối kết luận vô căn cứ.
- Vận hành: độ trễ đầu-cuối, lỗi tích hợp, giới hạn tốc độ và khả năng quan sát từng bước.
- Kinh tế: chi phí cho một tác vụ hoàn tất, bao gồm retry, tool call và thời gian review.
- An toàn: quyền truy cập repository, dữ liệu nhạy cảm, secret và các hành động có thể đảo ngược.
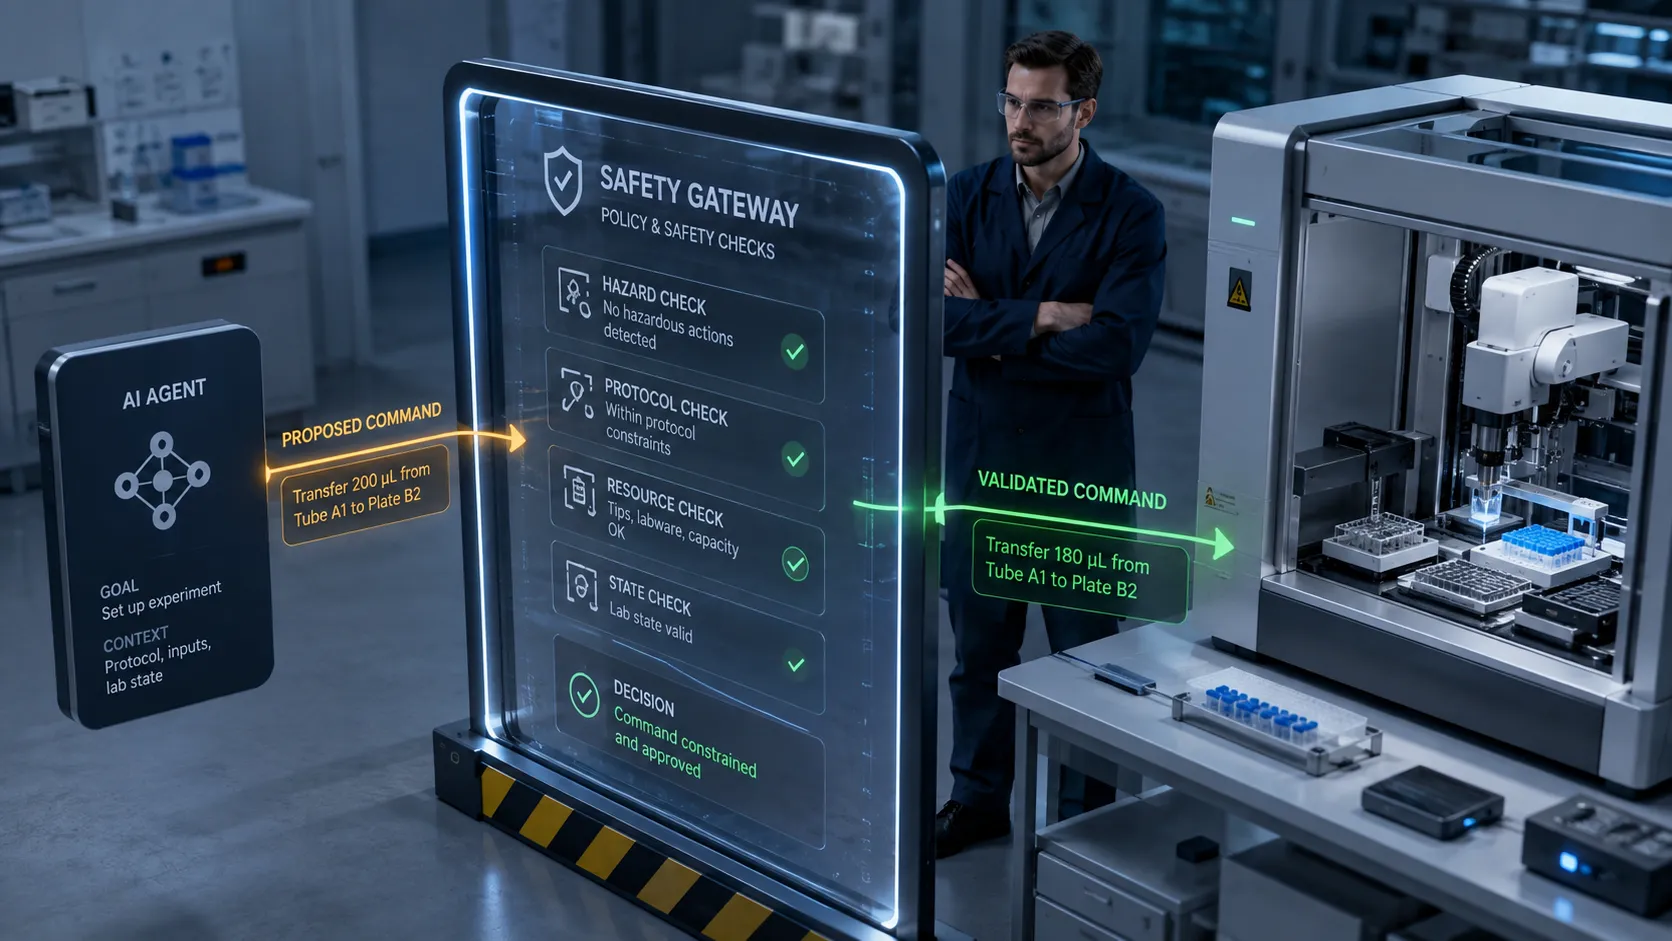
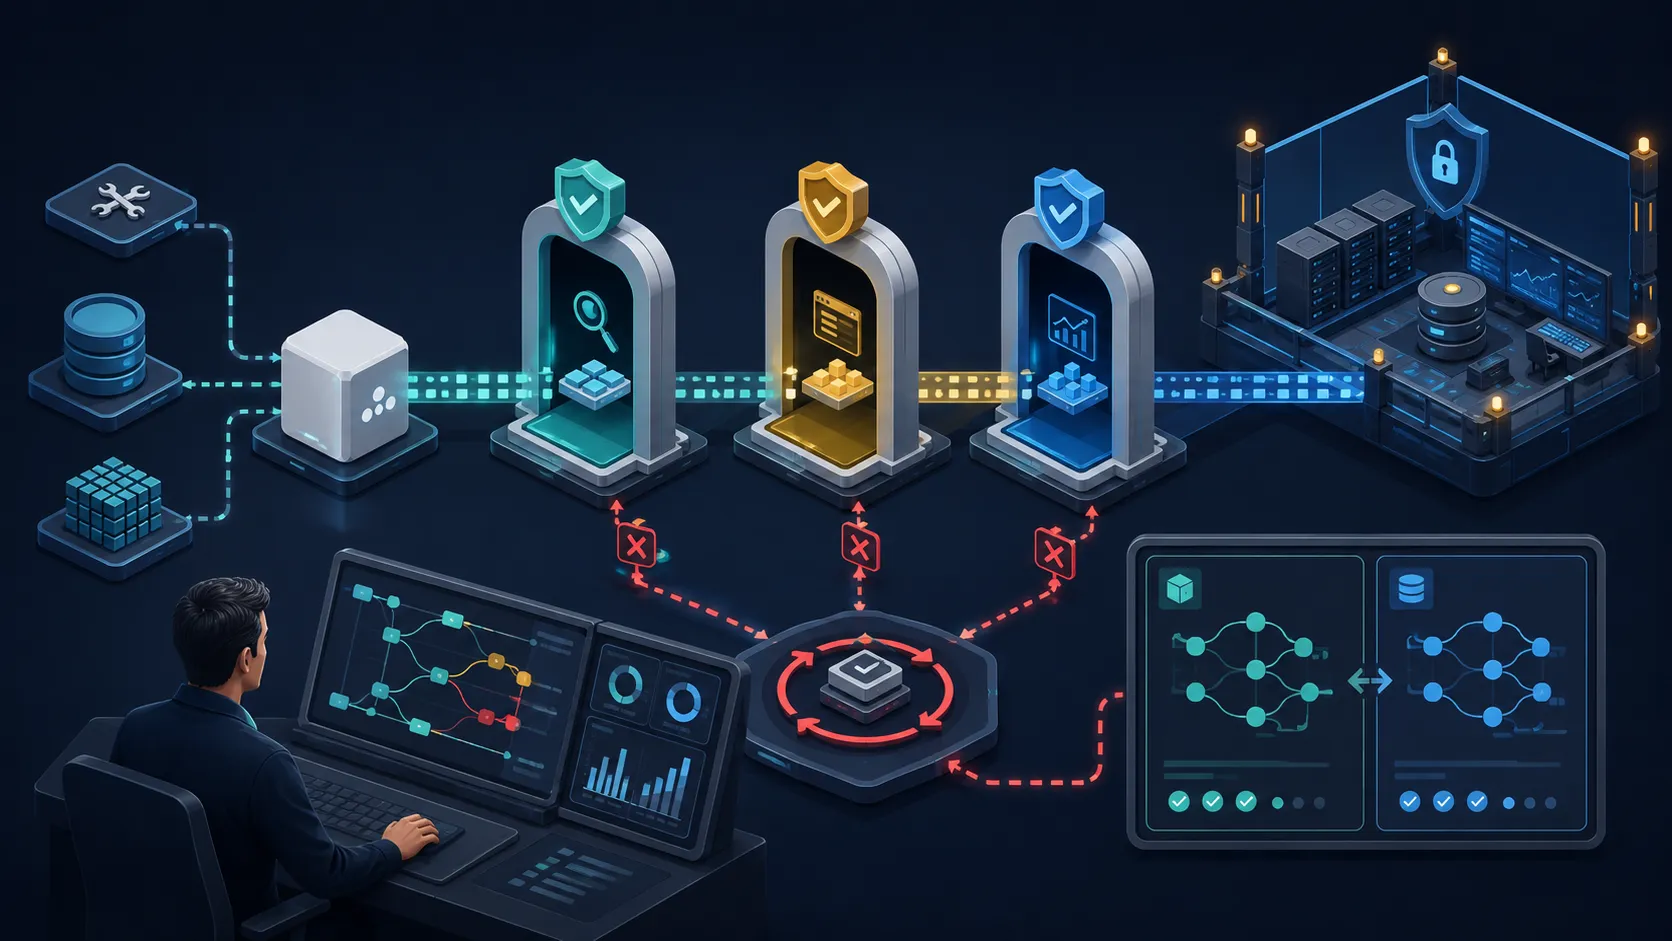
Đặc biệt với workflow có tính agent, năng lực mô hình và độ an toàn của hệ thống là hai vấn đề khác nhau. Bài viết về đánh giá và kiểm soát AI agent trong production giải thích vì sao trace, policy và kiểm thử tình huống lỗi cần được thiết kế cùng lúc với prompt.
Nếu agent có thể gọi công cụ hoặc thực hiện giao dịch, hãy áp dụng đặc quyền tối thiểu, giới hạn chi tiêu, phê duyệt thủ công và nhật ký bất biến. Các rủi ro kiểm soát này được phân tích thêm trong bài AI agent có thể giao dịch.
Cần theo dõi gì trước khi đưa vào production?
Tài liệu kỹ thuật tiếp theo cần làm rõ ít nhất bốn nhóm thông tin: cách truy cập mô hình, giới hạn sử dụng, dữ liệu đánh giá và điều kiện thương mại. Nếu thiếu một trong các nhóm này, đội ngũ khó lập ngân sách hoặc thiết kế cơ chế fallback đáng tin cậy.
Cũng cần tìm benchmark theo từng loại workload thay vì chỉ một điểm tổng hợp. Một kết quả coding nên cho biết môi trường chạy test và tiêu chí thành công; một đánh giá nghiên cứu cần nêu nguồn dữ liệu, quy trình kiểm chứng và mức tham gia của chuyên gia. Benchmark do nhà cung cấp công bố là tín hiệu ban đầu, không thay thế thử nghiệm trên mã và tài liệu riêng.
Cuối cùng, hãy kiểm tra chính sách dữ liệu, thời gian lưu giữ, quyền huấn luyện trên đầu vào và khả năng audit trước khi gửi tài sản trí tuệ. Cho đến khi Anthropic công bố đủ chi tiết, cách tiếp cận hợp lý là theo dõi tài liệu chính thức và chuẩn bị harness đánh giá, thay vì thiết kế lại hệ thống quanh các khả năng chưa được xác nhận.
Kết luận
- Claude Fable 5.1 và Claude Mythos 5.1 được giới thiệu cho coding, knowledge work và nghiên cứu.
- Thông tin hiện có chưa đủ để so sánh hai mô hình về chất lượng, tốc độ, giá hoặc cách truy cập.
- Tuyên bố về đóng góp khoa học cần được phân biệt với kết quả đã qua kiểm chứng.
- Đội ngũ nên dùng workload thật, kiểm soát quyền và chi phí mỗi tác vụ để đánh giá trước production.
Bài viết liên quan
- AI agent có thể giao dịch: Năng lực mới đi kèm rủi ro kiểm soát
- Kỹ thuật AI agent chuyển trọng tâm sang đánh giá và kiểm soát production
- Hạ tầng AI hút vốn lớn nhưng chi phí máy chủ đang tăng
Nguồn tham khảo
Vì sao developer cần quan tâm
Nếu các tuyên bố được kiểm chứng, hai mô hình có thể tác động đến cách đội ngũ xây trợ lý lập trình, quy trình nghiên cứu và agent. Tuy nhiên, quyết định production cần dựa trên benchmark nội bộ, khả năng kiểm soát và chi phí toàn hệ thống.
Hành động đề xuất
- 1Theo dõi tài liệu API, giá, giới hạn và benchmark chính thức; đồng thời chuẩn bị bộ đánh giá từ repository và tài liệu nội bộ trước khi thử nghiệm có kiểm soát.