Tóm tắt nhanh
- AI production đang buộc đội ngũ DevOps quản lý đồng thời năng lực GPU, mức ưu tiên suy luận, quy trình huấn luyện và khả năng tái tạo. Các hướng dẫn xoay quanh OpenShift AI cho thấy một kiến trúc thực tiễn kết nối tối ưu tài nguyên, model serving, observability và tự động hóa vòng đời.
- GPU đắt đỏ, lưu lượng suy luận biến động và chuỗi phụ thuộc AI phức tạp khiến cách vận hành Kubernetes truyền thống chưa đủ. Một control plane thống nhất giúp đội ngũ cân bằng chi phí, độ ổn định và tốc độ phát hành mô hình.
- Chọn một endpoint suy luận dùng GPU, đo baseline về utilization, hàng đợi, độ trễ và chất lượng; sau đó thử nghiệm riêng từng cơ chế tối ưu trước khi tự động hóa bằng GitOps.
Điều gì đã xảy ra
Đưa mô hình AI lên production không chỉ là triển khai thêm một container. Đội ngũ phải kiểm soát GPU khan hiếm, lưu lượng suy luận có mức ưu tiên khác nhau, các artefact mô hình lớn và môi trường thử nghiệm thường xuyên thay đổi.
Loạt hướng dẫn tập trung vào Red Hat OpenShift AI cho thấy DevOps dành cho AI đang hình thành theo ba lớp: quản trị năng lực tính toán, điều phối phục vụ mô hình và chuẩn hóa vòng đời từ notebook đến production. Đây không phải một sản phẩm đơn lẻ, mà là cách ghép nhiều cơ chế vận hành thành một hệ thống có thể kiểm soát.
Vì sao AI production thay đổi bài toán DevOps?
Ứng dụng web truyền thống thường mở rộng quanh CPU, bộ nhớ và số lượng request. AI bổ sung một tài nguyên có chi phí và ràng buộc lập lịch riêng là GPU, đồng thời tạo ra nhiều loại workload: notebook tương tác, fine-tuning theo lô, pipeline RAG và endpoint suy luận trực tuyến.
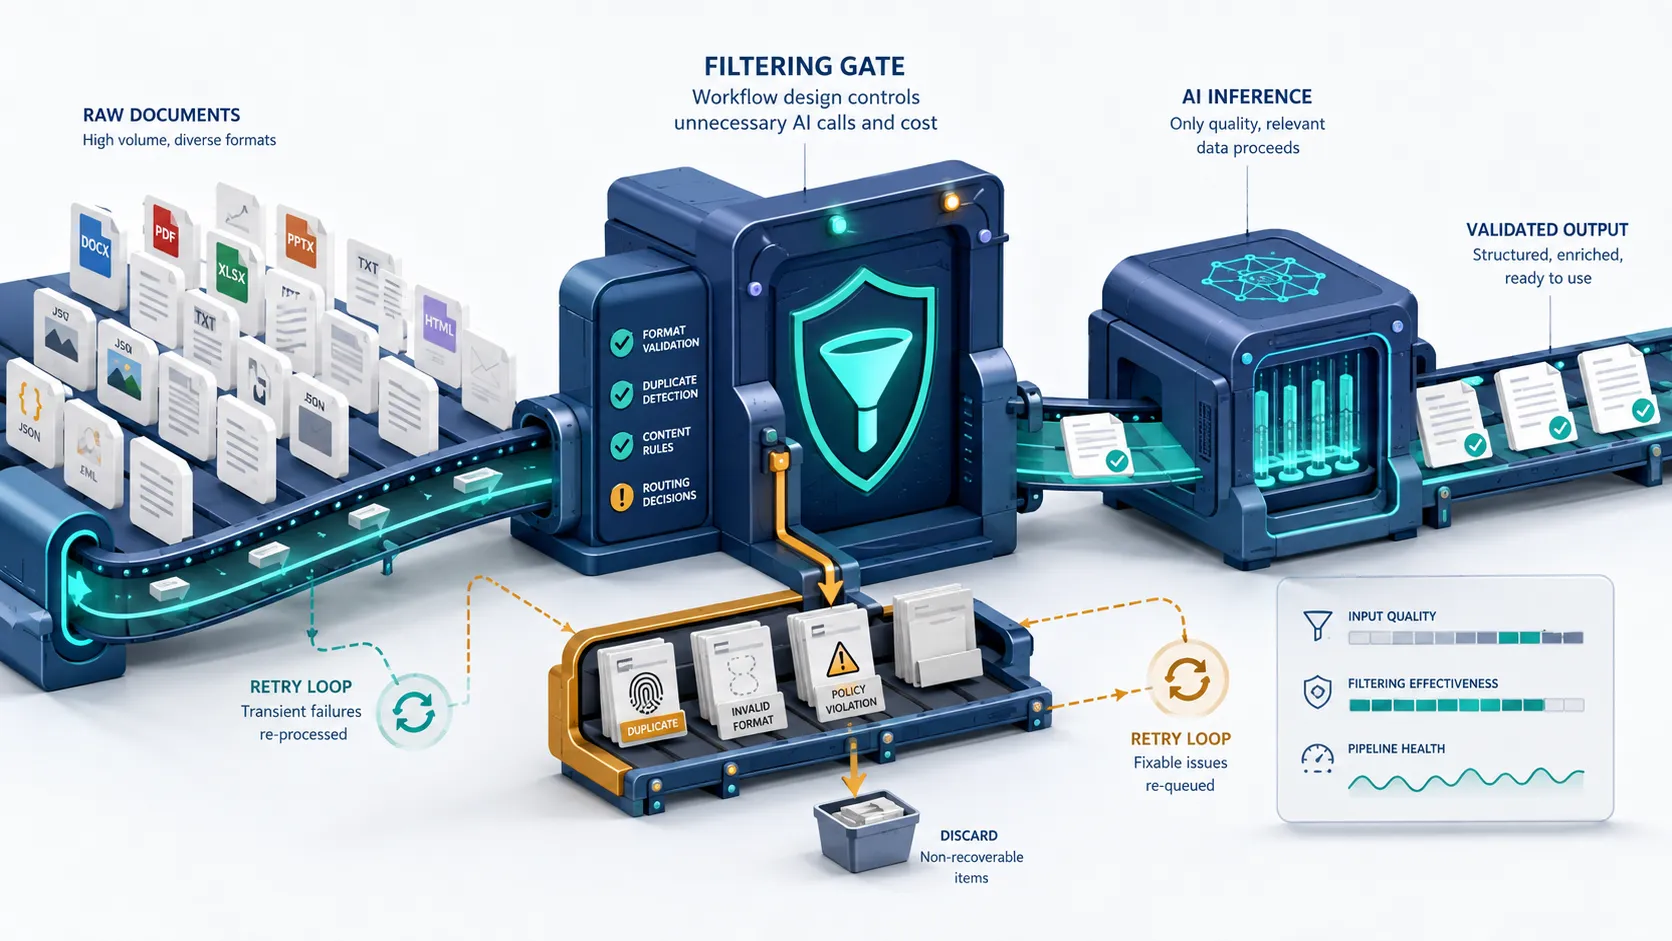
Khi những workload này dùng chung cluster, cấp phát thành công chưa đồng nghĩa với sử dụng hiệu quả. Hướng dẫn về GPU-pruner xử lý tình trạng lãng phí phân bổ GPU trong Kubernetes, nhấn mạnh rằng utilization phải được xem là vấn đề vận hành chứ không chỉ là quyết định mua phần cứng.
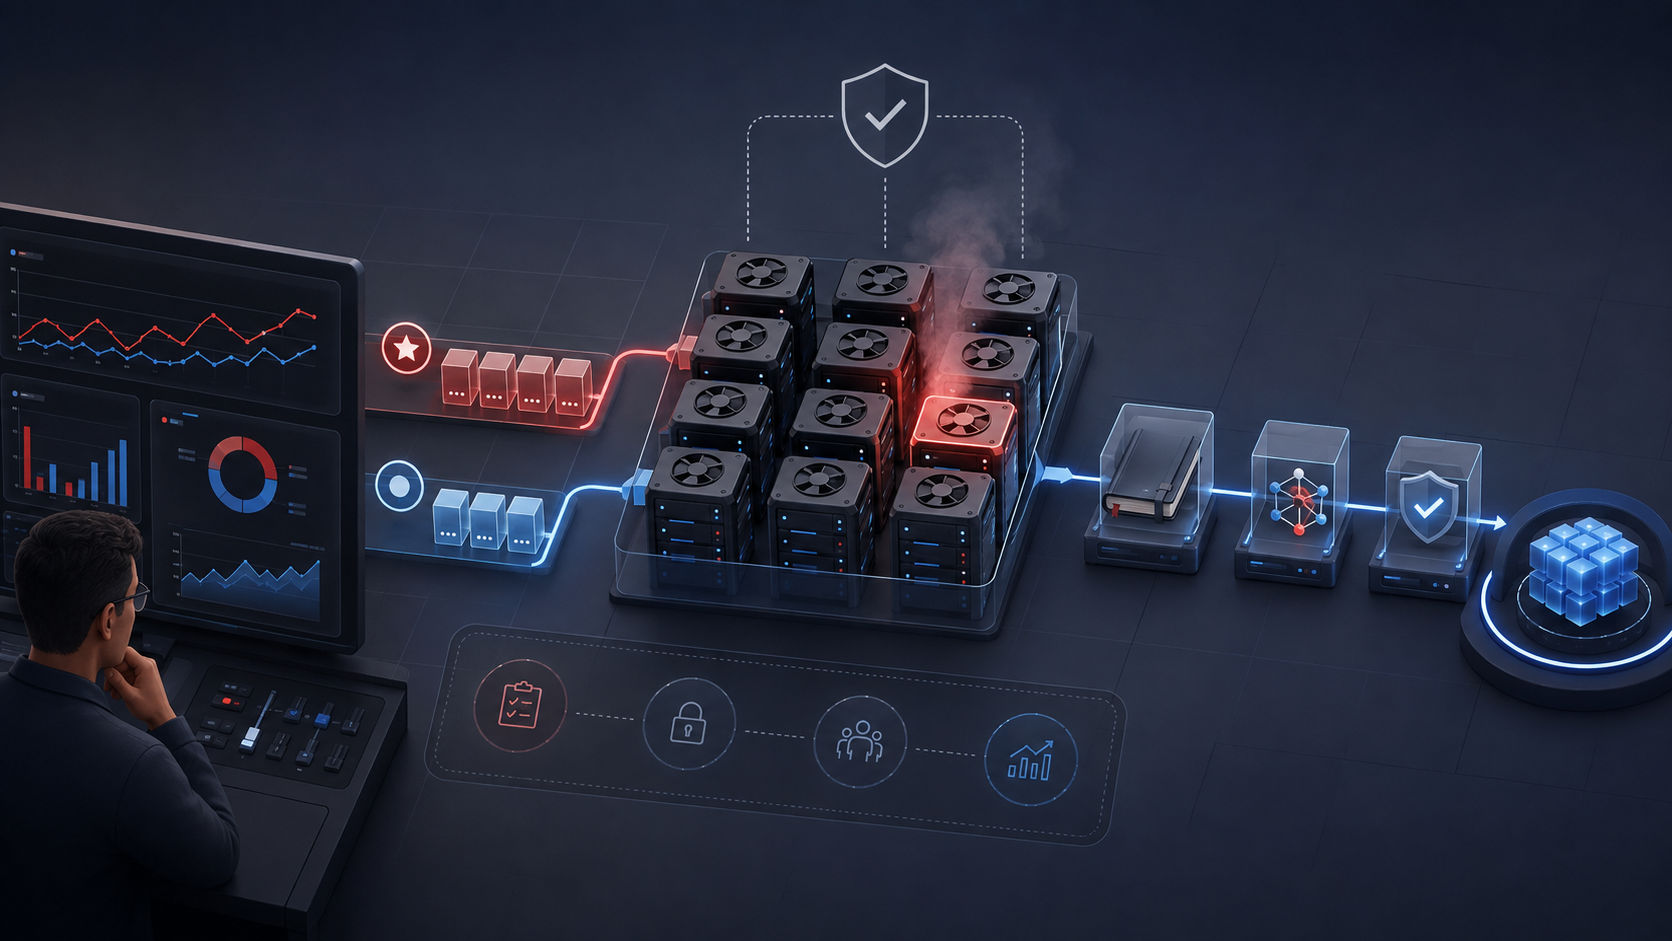
Độ trễ cũng không thể được quản lý chỉ bằng autoscaling. Batch nội bộ, yêu cầu thử nghiệm và request trực tiếp từ người dùng có giá trị khác nhau. Cơ chế priority queuing của llm-d cho suy luận dùng chung GPU đưa mức ưu tiên vào luồng xử lý, giúp nền tảng biểu diễn chính sách dịch vụ thay vì đối xử mọi request như nhau.
Kiểm soát GPU và model serving nên bắt đầu từ đâu?
Một kiến trúc thực dụng nên tách ba quyết định: workload nào được giữ GPU, request nào được phục vụ trước và mô hình nào phù hợp với giới hạn bộ nhớ hiện có. Nếu gộp chúng thành một biến “thêm replica”, đội ngũ khó xác định nguyên nhân khi chi phí tăng hoặc độ trễ suy giảm.
| Vấn đề | Cơ chế phù hợp | Tín hiệu cần theo dõi |
|---|---|---|
| GPU được cấp nhưng không tạo công việc hữu ích | Rà soát và thu hồi cấp phát không cần thiết | Thời gian nhàn rỗi và mức sử dụng GPU |
| Lưu lượng quan trọng bị chặn bởi tác vụ giá trị thấp | Hàng đợi và chính sách ưu tiên | Độ trễ theo lớp dịch vụ và độ sâu hàng đợi |
| Mô hình vượt giới hạn bộ nhớ hoặc phục vụ kém hiệu quả | Đánh giá lượng tử hóa | Bộ nhớ, thông lượng và chất lượng đầu ra |
Lượng tử hóa giảm độ chính xác số dùng để biểu diễn trọng số hoặc phép tính, nhưng không nên được coi là tối ưu “miễn phí”. Hướng dẫn lượng tử hóa LLM đặt kỹ thuật này trong bài toán triển khai; đội ngũ vẫn cần kiểm thử chất lượng trên dữ liệu và tác vụ thực tế của mình.
Với RAG, endpoint mô hình chỉ là một mắt xích. Truy xuất, chuẩn bị ngữ cảnh và sinh câu trả lời phải được vận hành như một pipeline, đúng với cách tiếp cận trong hướng dẫn điều phối RAG production bằng OpenShift AI. Hệ quả thực tế là SLO và telemetry cần bao phủ từng chặng, thay vì chỉ đo thời gian phản hồi cuối cùng.
Làm thế nào nối thử nghiệm, fine-tuning và quan sát?
Rủi ro vòng đời bắt đầu trước khi mô hình được triển khai. Notebook chứa package tải động hoặc phụ thuộc không được khóa có thể tạo ra kết quả khó tái tạo. Cách xây dựng hermetic notebook image cho Open Data Hub và OpenShift AI cho thấy môi trường phát triển cũng nên được quản lý như một artefact có phiên bản.
Ở lớp huấn luyện, phạm vi kỹ thuật có thể trải từ LoRA fine-tuning với Ray trên OpenShift AI đến GRPO dựa trên phần thưởng có thể xác minh. Hai hướng này không thể thay thế lẫn nhau; chúng đại diện cho những lựa chọn khác nhau về mục tiêu, dữ liệu, tài nguyên và phương pháp đánh giá.
Mỗi lần chạy cần để lại đủ thông tin để so sánh và truy vết. Hướng dẫn về AI observability với MLflow đặt theo dõi thử nghiệm và mô hình vào bức tranh vận hành. Tuy nhiên, observability hữu ích chỉ khi metadata huấn luyện, phiên bản mô hình, cấu hình serving và chỉ số production được liên kết bằng định danh nhất quán.
Đây là nơi tư duy control plane trở nên quan trọng. Tương tự nguyên tắc trong thiết kế control plane tự động hóa có quản trị, quyền thay đổi, trạng thái mong muốn và dấu vết kiểm toán cần được tách khỏi thao tác thủ công trên từng workload.
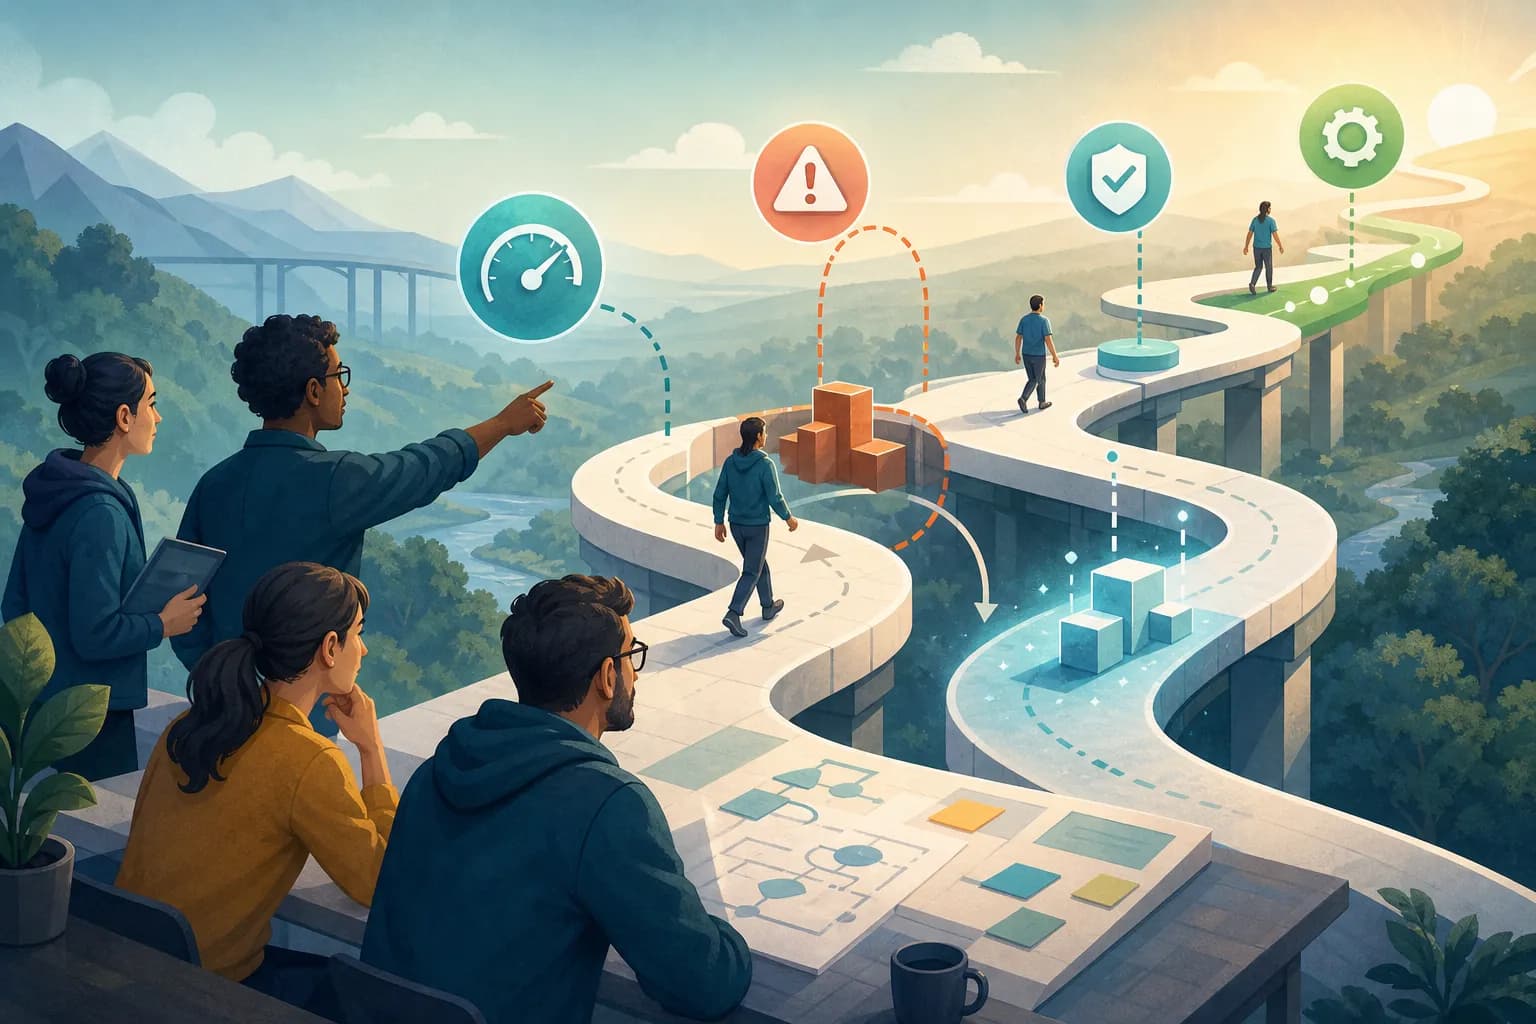
Một lộ trình triển khai ít rủi ro
Không nên đưa toàn bộ stack vào production cùng lúc. Hãy bắt đầu từ một dịch vụ có lưu lượng đo được, một mô hình đã có bộ đánh giá và một nhóm người dùng đủ rõ để thiết lập ưu tiên.
- Lập baseline: ghi nhận cấp phát và sử dụng GPU, độ trễ theo percentile, độ sâu hàng đợi, lỗi và chất lượng đầu ra hiện tại.
- Phân loại workload: tách notebook, fine-tuning, batch inference và online inference; xác định workload nào có thể chờ hoặc bị thu hồi.
- Đặt chính sách phục vụ: định nghĩa lớp ưu tiên và hành vi khi quá tải trước khi cấu hình hàng đợi.
- Chuẩn hóa artefact: phiên bản hóa notebook image, cấu hình huấn luyện, model artefact và manifest triển khai.
- Tự động hóa có kiểm soát: dùng Helm hoặc GitOps như một lựa chọn triển khai, nhưng yêu cầu review, rollback và kiểm tra policy thay vì đồng bộ mù quáng.
Đây là đề xuất kiến trúc, không phải đảm bảo rằng một cấu hình sẽ phù hợp cho mọi cluster. Đội ngũ nên thử nghiệm trên phạm vi nhỏ và đánh giá riêng tác động của lượng tử hóa, ưu tiên request hoặc thu hồi GPU trước khi kết hợp chúng.
Kết luận
- DevOps cho AI phải quản trị GPU, request và artefact mô hình như ba lớp riêng nhưng có liên kết.
- Priority queue và quản lý cấp phát giải quyết hai vấn đề khác nhau: chất lượng dịch vụ và hiệu quả năng lực.
- Môi trường notebook có thể tái tạo và metadata nhất quán là nền tảng cho observability đáng tin cậy.
- Nên triển khai theo từng bước, đo baseline và giữ khả năng rollback ở mọi thay đổi production.
Bài viết liên quan
- Ventura React: thư viện component nhẹ còn phù hợp cho dự án mới?
- Nova MCP: Biến AI trong Cursor và Claude thành đội ngũ sản phẩm
- Ansible Automation Orchestrator: thiết kế control plane có quản trị
Nguồn tham khảo
- Run LoRA fine-tuning on Red Hat OpenShift AI with Ray
- Building hermetic notebook images for Open Data Hub and Red Hat OpenShift AI
- llm-d flow control: Priority queuing for shared GPU inference
- How AI observability works with MLflow
- GRPO fine-tuning on Red Hat OpenShift AI: Reinforcement learning from verifiable...
- LLM quantization guide: How to do it, and how it helps
- Orchestrate production RAG with OpenShift AI
- Stop wasting GPU allocation in Kubernetes with GPU-pruner
Vì sao developer cần quan tâm
GPU đắt đỏ, lưu lượng suy luận biến động và chuỗi phụ thuộc AI phức tạp khiến cách vận hành Kubernetes truyền thống chưa đủ. Một control plane thống nhất giúp đội ngũ cân bằng chi phí, độ ổn định và tốc độ phát hành mô hình.
Hành động đề xuất
- 1Chọn một endpoint suy luận dùng GPU, đo baseline về utilization, hàng đợi, độ trễ và chất lượng; sau đó thử nghiệm riêng từng cơ chế tối ưu trước khi tự động hóa bằng GitOps.