Tóm tắt nhanh
- Google Cloud đặt vấn đề tối ưu chi phí khi đưa tác vụ GenAI vào pipeline dữ liệu trên Dataflow. Với đội ngũ kỹ thuật, điểm quan trọng không chỉ là gọi mô hình thành công mà còn là kiểm soát dữ liệu đầu vào, số lần suy luận, lỗi thử lại và khả năng quan sát toàn workflow.
- Chi phí GenAI có thể tăng theo lưu lượng dữ liệu và cách pipeline điều phối suy luận. Thiết kế đo lường được từ đầu giúp nhóm phát hiện lãng phí, thử nghiệm an toàn và vận hành workload AI bền vững hơn.
- Chọn một workflow GenAI đại diện, lập đường cơ sở cho tỷ lệ gọi mô hình, thử lại và chi phí trên mỗi kết quả hợp lệ, sau đó thử tối ưu từng biến trước khi mở rộng.
Điều gì đã xảy ra
Đưa AI tạo sinh vào pipeline dữ liệu có thể tự động hóa việc làm giàu, phân loại hoặc chuyển đổi nội dung, nhưng mỗi lần suy luận đều tạo thêm chi phí và độ trễ. Khi khối lượng dữ liệu tăng, một workflow chạy đúng về chức năng vẫn có thể trở nên khó dự toán nếu nhóm chưa xác định rõ dữ liệu nào thực sự cần đến mô hình.
Bài viết chính thức của Google Cloud về workflow GenAI tiết kiệm chi phí trong Dataflow đặt trọng tâm vào chính bài toán này. Crawl record không cung cấp cấu hình, số liệu benchmark hay mức giá cụ thể, vì vậy phần dưới tập trung vào cách đọc vấn đề và các bước thiết kế có thể áp dụng mà không suy diễn về tính năng chưa được xác nhận.
Chi phí thực sự phát sinh ở đâu?
Một pipeline GenAI không chỉ có chi phí của lời gọi mô hình. Tổng chi phí vận hành còn chịu ảnh hưởng bởi lượng dữ liệu được đọc và ghi, số bản ghi đi qua bước suy luận, dữ liệu trung gian, thời gian xử lý, lỗi và các lần thử lại.
Có thể dùng một mô hình tư duy đơn giản: chi phí workflow bằng chi phí xử lý dữ liệu cộng chi phí suy luận và chi phí phát sinh do vận hành. Đây không phải công thức định giá của Google Cloud mà là khung phân tích để nhóm tìm ra biến số mình có thể kiểm soát.
- Khối lượng: bao nhiêu bản ghi hoặc tài liệu thực sự phải được xử lý?
- Tần suất: cùng một dữ liệu có bị gửi đến mô hình nhiều lần không?
- Kích thước yêu cầu: prompt và ngữ cảnh có chứa phần dư thừa không?
- Độ tin cậy: lỗi tạm thời có gây thử lại hàng loạt hoặc xử lý trùng lặp không?
- Dữ liệu đầu ra: kết quả nào cần lưu lâu dài và kết quả nào chỉ mang tính trung gian?
Việc tách các thành phần này giúp tránh một sai lầm phổ biến: chỉ theo dõi hóa đơn mô hình trong khi bỏ qua chi phí của cả đường đi dữ liệu.
Nên đặt suy luận ở vị trí nào trong pipeline?
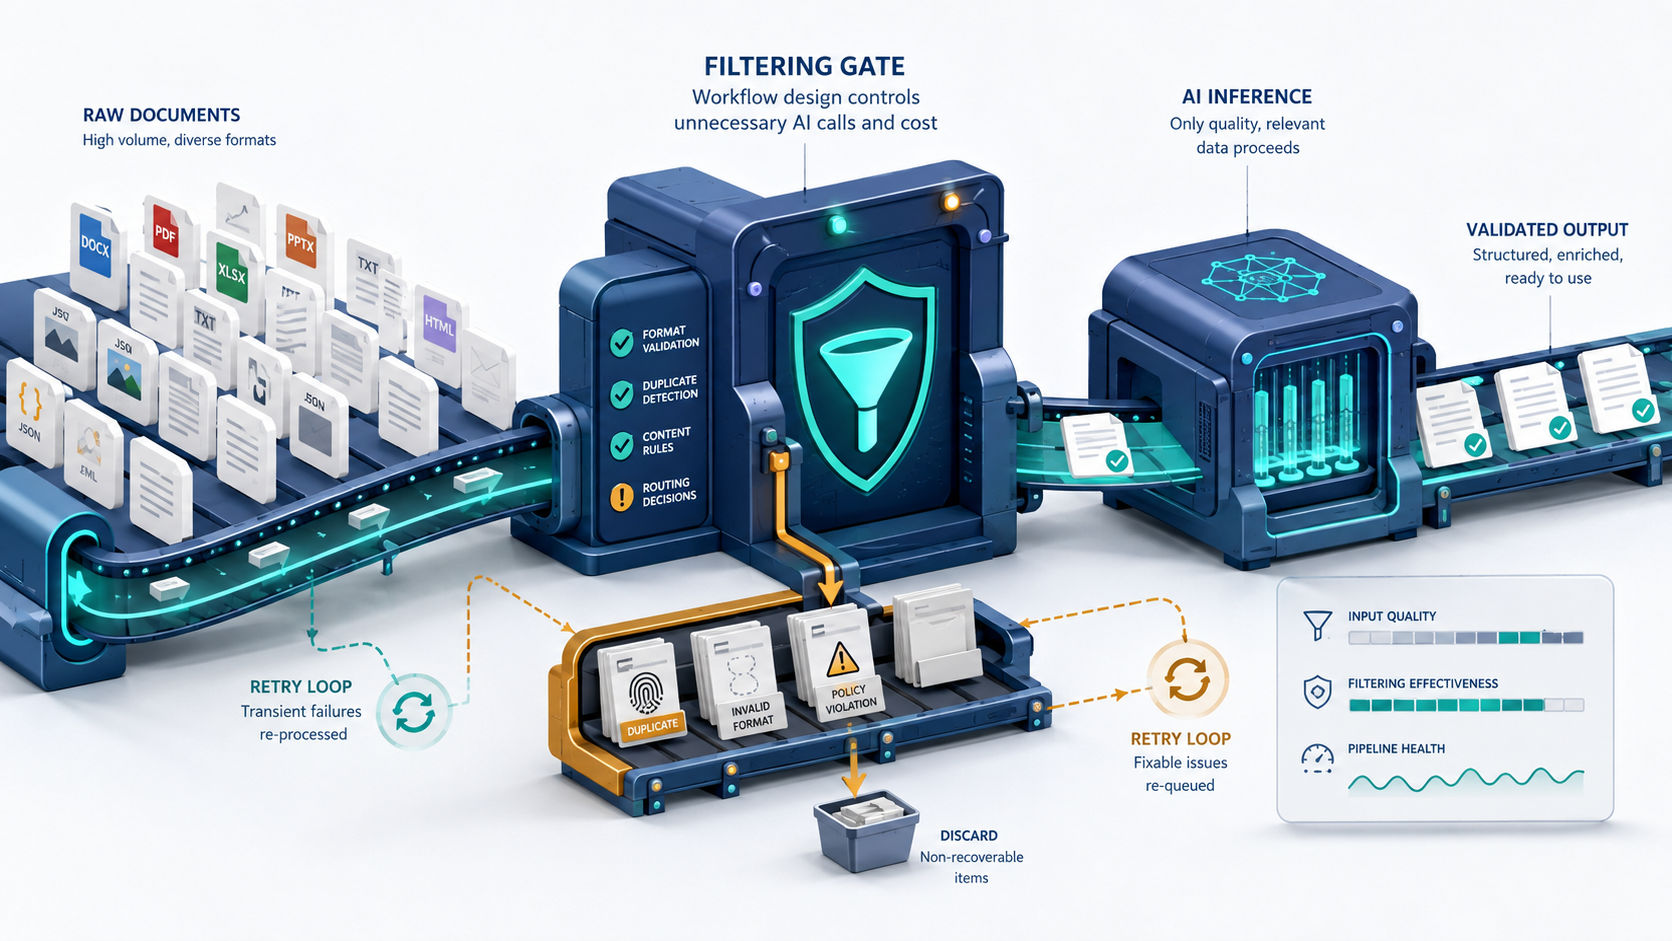
Quyết định quan trọng nhất thường không phải chọn mô hình trước, mà là xác định bản ghi nào đủ điều kiện đi tới bước suy luận. Lọc dữ liệu không hợp lệ, loại bỏ bản sao và chuẩn hóa đầu vào trước đó có thể giảm số yêu cầu không tạo ra giá trị.
Nhóm cũng nên phân biệt tác vụ bắt buộc với tác vụ bổ sung. Nếu kết quả GenAI chỉ dùng để tăng chất lượng siêu dữ liệu, workflow có thể thiết kế để lỗi ở bước này không làm mất toàn bộ tiến trình; ngược lại, một quyết định nghiệp vụ phụ thuộc hoàn toàn vào đầu ra mô hình cần cơ chế kiểm tra chặt hơn.
Một luồng hợp lý về mặt thiết kế có thể gồm: tiếp nhận dữ liệu, xác thực, loại trùng, định tuyến theo loại tác vụ, gọi mô hình khi cần, kiểm tra đầu ra rồi mới lưu kết quả. Đây là khuyến nghị kiến trúc tổng quát, không phải mô tả cấu hình Dataflow cụ thể.
Đo lường gì trước khi tối ưu?
Tối ưu khi thiếu số liệu thường chỉ chuyển chi phí từ vị trí này sang vị trí khác. Trước khi thay đổi kiến trúc, đội ngũ nên tạo một đường cơ sở cho số bản ghi đầu vào, tỷ lệ được gửi đến mô hình, tỷ lệ thành công, số lần thử lại và thời gian hoàn tất.
Nên gắn số liệu vận hành với một đơn vị giá trị nghiệp vụ, chẳng hạn chi phí trên mỗi tài liệu được làm giàu thành công. Cách nhìn này hữu ích hơn một con số tổng vì nó cho biết chi phí tăng do hệ thống lãng phí hay đơn giản do sản lượng hữu ích tăng.
Quan sát pipeline dữ liệu và quan sát model serving cần được xem như một chuỗi liên tục. Bài viết về DevOps cho AI production và tối ưu model serving cung cấp thêm góc nhìn về lớp vận hành phía sau suy luận.
Quy trình triển khai an toàn cho đội ngũ
Trước tiên, hãy chạy workload đại diện ở quy mô giới hạn và ghi lại giả định về lưu lượng, lỗi cũng như chất lượng đầu ra. Sau đó, thay đổi từng biến một—lọc đầu vào, rút gọn ngữ cảnh hoặc điều chỉnh chính sách thử lại—để xác định nguyên nhân thực sự của chênh lệch.
- Chọn một trường hợp sử dụng có tiêu chí thành công đo được.
- Lập bản đồ các bước xử lý trước và sau suy luận.
- Đặt giới hạn thử nghiệm về lưu lượng và ngân sách.
- Theo dõi tỷ lệ lọc, gọi mô hình, lỗi, thử lại và kết quả hợp lệ.
- Chỉ mở rộng khi chi phí trên một kết quả hữu ích nằm trong ngưỡng chấp nhận.
Khi workflow chuyển sang production, quyền thay đổi cấu hình, quy trình phê duyệt và khả năng truy vết cũng trở nên quan trọng. Cách tiếp cận control plane có quản trị trong thiết kế Ansible Automation Orchestrator là một tham chiếu hữu ích cho tư duy kiểm soát thay đổi, dù công nghệ và workload khác nhau.
Kết luận
- Chi phí GenAI phải được đánh giá trên toàn pipeline, không chỉ tại lời gọi mô hình.
- Lọc, loại trùng và định tuyến trước suy luận là các điểm kiểm soát cần đo lường.
- Hãy theo dõi chi phí trên mỗi kết quả hữu ích thay vì chỉ nhìn tổng chi tiêu.
- Thử nghiệm giới hạn và mở rộng theo dữ liệu giúp giảm rủi ro vận hành.
Bài viết liên quan
- DevOps cho AI production: Tối ưu GPU và vận hành model serving
- Ansible Automation Orchestrator: thiết kế control plane có quản trị
Nguồn tham khảo
News, tips, and inspiration to accelerate your digital transformation
Vì sao developer cần quan tâm
Chi phí GenAI có thể tăng theo lưu lượng dữ liệu và cách pipeline điều phối suy luận. Thiết kế đo lường được từ đầu giúp nhóm phát hiện lãng phí, thử nghiệm an toàn và vận hành workload AI bền vững hơn.
Hành động đề xuất
- 1Chọn một workflow GenAI đại diện, lập đường cơ sở cho tỷ lệ gọi mô hình, thử lại và chi phí trên mỗi kết quả hợp lệ, sau đó thử tối ưu từng biến trước khi mở rộng.