Tóm tắt nhanh
- Banksalad giới thiệu chủ đề sử dụng LLM để tạo dữ liệu kiểm thử, nhưng bản ghi nguồn được cung cấp không nêu kiến trúc hay kết quả triển khai. Bài viết phân định những gì đã được xác nhận và đưa ra khung đánh giá thực tế cho các nhóm muốn thử cách tiếp cận tương tự.
- LLM có thể mở rộng cách nhóm kỹ thuật xây dựng dữ liệu kiểm thử, nhưng chỉ hữu ích khi đầu ra được kiểm tra theo schema, quy tắc nghiệp vụ, quyền riêng tư và khả năng tái lập.
- Đọc bài viết gốc để kiểm tra chi tiết triển khai, sau đó thử nghiệm trên một schema không nhạy cảm với validator xác định và fixture cơ sở.
Điều gì đã xảy ra
Banksalad đã công bố một bài viết về cách tạo dữ liệu kiểm thử với sự hỗ trợ của LLM. Đây là một bài toán thực tế: dữ liệu giả phải đủ đa dạng để giúp phát hiện lỗi, nhưng đồng thời phải hợp lệ, an toàn và có thể dùng lại trong quy trình phát triển.
Tuy nhiên, phần thông tin nguồn được cung cấp chỉ xác nhận chủ đề của bài viết, không mô tả mô hình, prompt, kiến trúc, benchmark hay kết quả vận hành. Vì vậy, cần tách rõ nội dung đã được xác nhận khỏi các khuyến nghị kỹ thuật dành cho nhóm muốn đánh giá phương pháp này.
Thông tin nào đã được Banksalad xác nhận?
Bài viết chính thức trên Banksalad Tech được giới thiệu là nội dung trình bày cách Banksalad tạo dữ liệu kiểm thử với LLM. Tiêu đề và phần tóm tắt nguồn xác nhận phạm vi đó, nhưng không cung cấp thêm chi tiết triển khai trong dữ liệu đầu vào hiện có.
Do đó, chưa thể kết luận Banksalad dùng nhà cung cấp mô hình nào, dữ liệu được sinh theo batch hay theo yêu cầu, đầu ra được kiểm tra ra sao hoặc hệ thống có tiếp xúc với dữ liệu sản xuất hay không. Cũng không có bằng chứng được cung cấp về mức tiết kiệm thời gian, chất lượng dữ liệu hoặc tỷ lệ lỗi.
Ranh giới bằng chứng này rất quan trọng. Một hệ thống tạo vài fixture cho giao diện khác đáng kể so với nền tảng tạo tập dữ liệu có quan hệ cho dịch vụ tài chính, và không nên suy diễn kiến trúc chỉ từ cụm từ “feat. LLM”.
LLM nên đảm nhiệm phần nào trong quy trình?
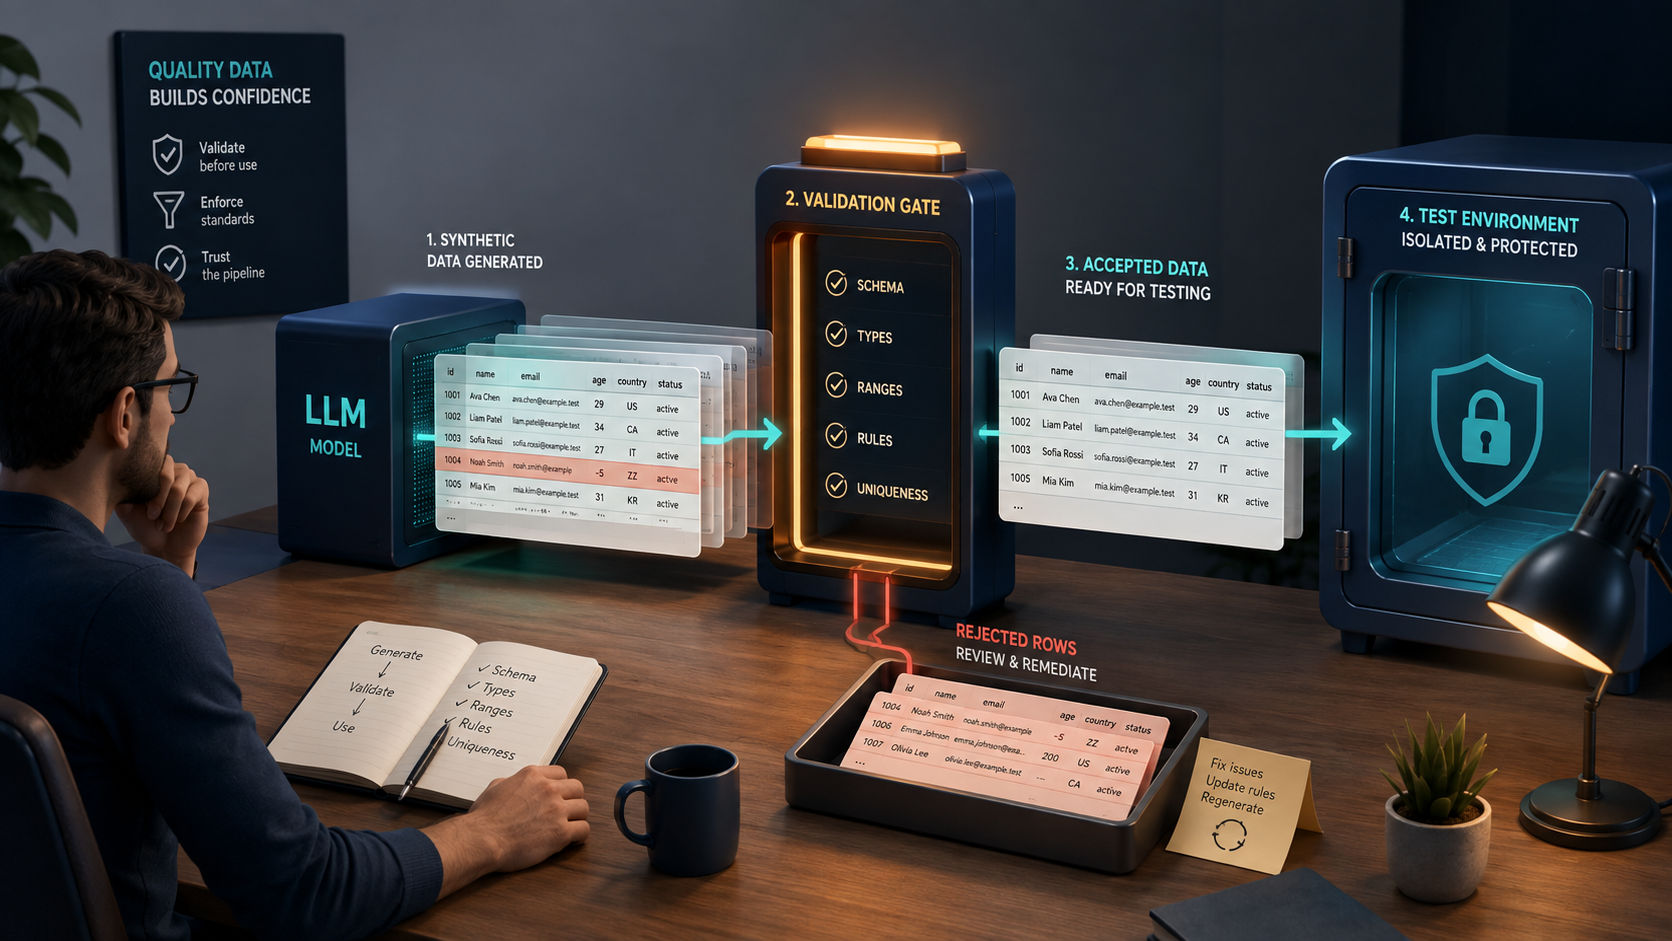
Với một thử nghiệm nội bộ, nhóm kỹ thuật nên bắt đầu bằng việc xác định rõ vai trò dự kiến của LLM. Mô hình có thể được đánh giá như công cụ tạo ứng viên dữ liệu, trong khi schema, kiểu dữ liệu và quy tắc nghiệp vụ vẫn do mã xác định kiểm tra.
Đây là khuyến nghị triển khai, không phải mô tả hệ thống của Banksalad. Một quy trình đánh giá tối thiểu có thể gồm:
- Xác định schema, trường bắt buộc và quan hệ giữa các bản ghi trước khi viết prompt.
- Yêu cầu đầu ra ở định dạng có thể phân tích cú pháp, sau đó từ chối mọi bản ghi không hợp lệ.
- Kiểm tra uniqueness, phạm vi giá trị, quan hệ tham chiếu và các bất biến nghiệp vụ bằng mã.
- Đưa dữ liệu đã qua kiểm tra vào môi trường kiểm thử cô lập thay vì coi phản hồi của mô hình là dữ liệu đáng tin cậy.
- Lưu cấu hình sinh dữ liệu cần thiết để điều tra khi bộ kiểm thử thay đổi hành vi.
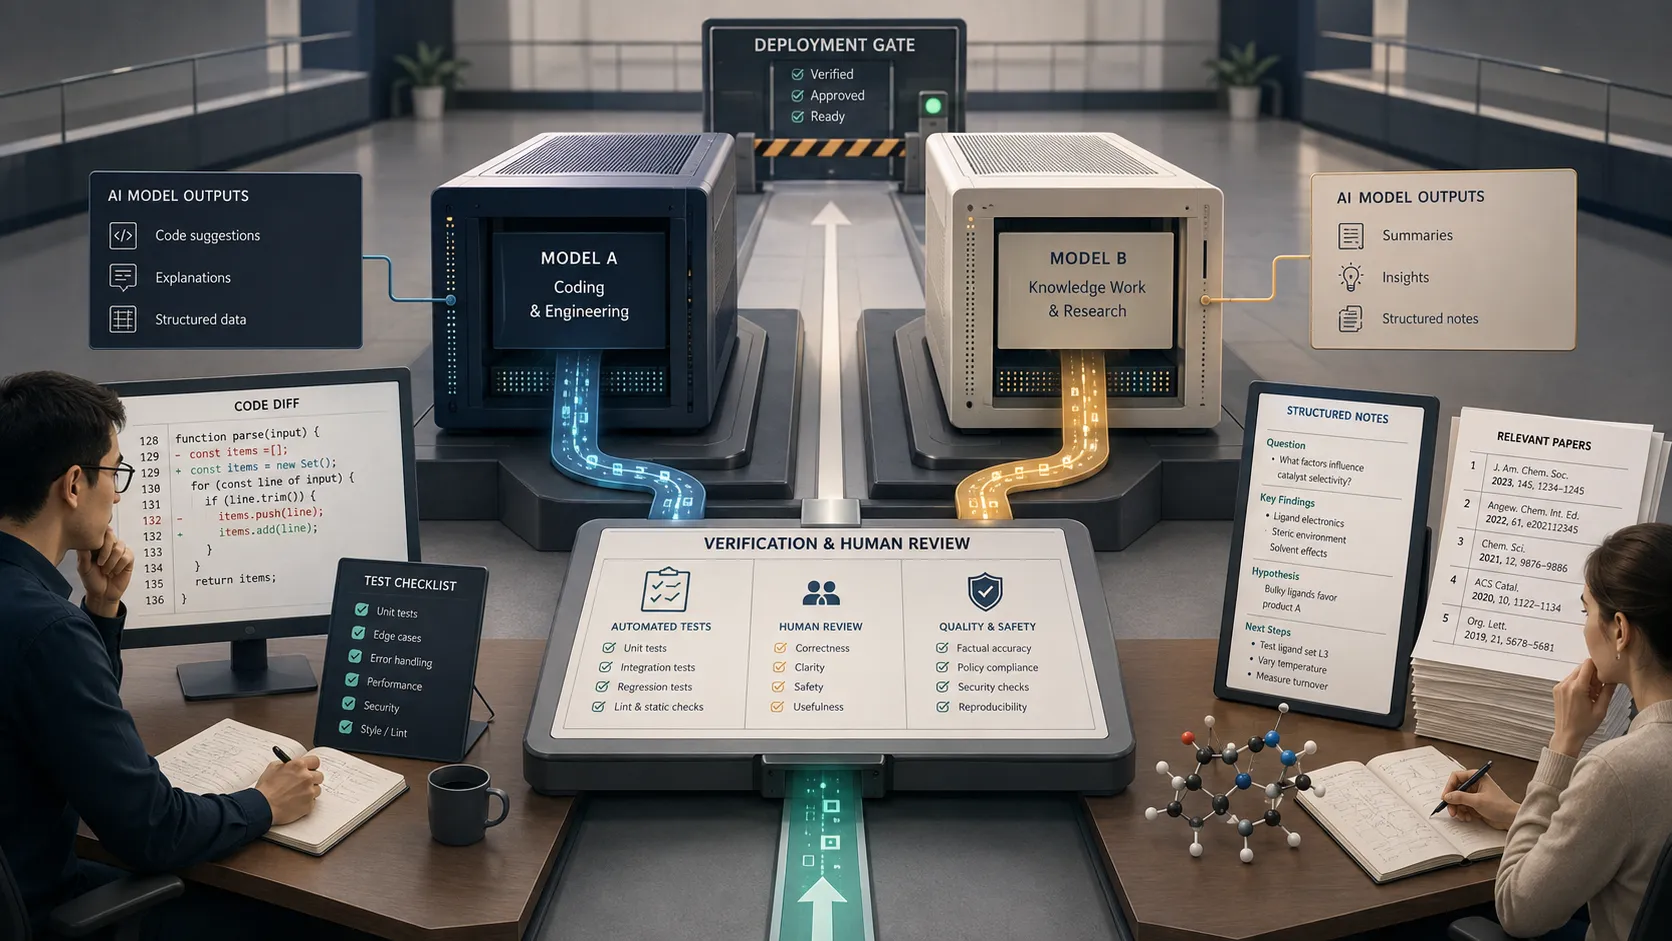
Cách phân vai này giúp tránh biến LLM thành nguồn phán quyết duy nhất. Mô hình đề xuất dữ liệu; validator và test runner quyết định dữ liệu đó có được chấp nhận hay không.
Những rủi ro nào cần được chặn trước khi thử nghiệm?
Rủi ro đầu tiên là quyền riêng tư. Không nên đưa bản ghi khách hàng, thông tin nhận dạng hoặc bí mật hệ thống vào prompt nếu chưa có chính sách, phê duyệt và biện pháp xử lý dữ liệu phù hợp. Dữ liệu “giả” cũng cần được nhận diện rõ để tránh bị nhầm với dữ liệu thật trong log, dashboard hoặc công cụ hỗ trợ.
Rủi ro thứ hai là tính hợp lệ bề mặt. Một bản ghi có thể đúng JSON nhưng vẫn vi phạm logic nghiệp vụ, tạo quan hệ không tồn tại hoặc che khuất trường hợp biên quan trọng. Validation vì thế phải được xây dựng từ hợp đồng dữ liệu và bất biến của ứng dụng, không dựa vào việc đầu ra trông có vẻ hợp lý.
Cuối cùng là khả năng tái lập. Nếu cùng một bộ kiểm thử nhận dữ liệu khác nhau giữa các lần chạy, việc phân biệt regression thật với biến động của dữ liệu sẽ khó hơn. Nhóm nên quyết định phần nào cần fixture ổn định và phần nào có thể chấp nhận dữ liệu khám phá có biến thiên.
Làm sao đánh giá một thử nghiệm nhỏ mà không làm phức tạp hệ thống?
Thay vì thay thế toàn bộ fixture hiện có, hãy chọn một luồng không chứa dữ liệu nhạy cảm và có quy tắc chấp nhận rõ ràng. So sánh dữ liệu do LLM hỗ trợ với phương pháp hiện tại theo các tiêu chí do nhóm định nghĩa trước, chẳng hạn tỷ lệ qua validator, số trường hợp biên hữu ích và công sức cần để sửa đầu ra.
Giữ một tập fixture xác định làm đường cơ sở. LLM phù hợp hơn với vai trò mở rộng biến thể hoặc đề xuất tình huống chưa được nghĩ tới; nó không nên mặc nhiên thay thế các ca regression cần lặp lại chính xác.
Nếu thử nghiệm được đưa vào pipeline rộng hơn, cần bổ sung giới hạn chi phí, timeout, xử lý lỗi và đường lui khi dịch vụ mô hình không khả dụng. Đây cũng là lý do các nguyên tắc kiểm soát trong bài về vận hành web AI agent ngoài prompting có liên quan: hành vi của mô hình phải nằm sau các rào chắn có thể quan sát và kiểm tra.
Kết luận
- Nguồn xác nhận Banksalad giới thiệu việc tạo dữ liệu kiểm thử với LLM, nhưng dữ liệu được cung cấp không đủ để tái dựng kiến trúc.
- Không nên xem đầu ra của mô hình là dữ liệu hợp lệ nếu chưa qua validator xác định.
- Quyền riêng tư, phân tách môi trường và khả năng tái lập phải được đặt ra trước thử nghiệm.
- Nên bắt đầu bằng một luồng nhỏ, có fixture cơ sở và tiêu chí thành công đo được.
Bài viết liên quan
- API trình duyệt gốc đang thay đổi cách xây dựng web tương tác
- Tối ưu web cache cần bắt đầu từ bộ nhớ, lưu trữ và chi phí đo được
- Web AI agent cần gì để vận hành ổn định ngoài prompting?
Nguồn tham khảo
Vì sao developer cần quan tâm
LLM có thể mở rộng cách nhóm kỹ thuật xây dựng dữ liệu kiểm thử, nhưng chỉ hữu ích khi đầu ra được kiểm tra theo schema, quy tắc nghiệp vụ, quyền riêng tư và khả năng tái lập.
Hành động đề xuất
- 1Đọc bài viết gốc để kiểm tra chi tiết triển khai, sau đó thử nghiệm trên một schema không nhạy cảm với validator xác định và fixture cơ sở.